
ArticleCybersécurité
Un format accepté ne prouve pas qu’une vérification fonctionne
SecTB-RTL documente un incident où le fournisseur accepte des réponses structurées mais où le validateur de production n’en reconnaît presque aucune.
Éditorial / 24 publications
Des méthodes et des tutoriels lisibles hors ligne pour tester les outils, vérifier leurs limites et construire des workflows durables.
À lire
SecTB-RTL documente un incident où le fournisseur accepte des réponses structurées mais où le validateur de production n’en reconnaît presque aucune.
Une architecture LSTM multi-flux évaluée sur plusieurs indices avec une séparation chronologique stricte, mais encore limitée à un cadre expérimental.
Une représentation inspirée de l'Auction Market Theory pour le trading intraday, avec des résultats élevés mais un périmètre empirique étroit.
Une architecture qui sépare dynamique temporelle et structure multi-échelle pour prévoir des indices, avec une validation chronologique à lire avec prudence.
Une étude compare la désambiguïsation lexicale sans inventaire de sens et la sélection guidée par des définitions candidates.
Workspace Models compresse les éléments utiles d'une histoire visuelle en un état latent interrogable au déploiement.
Xeno-Interpretability propose de rechercher des représentations natives du modèle même lorsque leur sens ne correspond à aucun concept humain simple.
YOLO12-MambaScan combine des chemins haute fréquence, une attention spatiale et Mamba pour détecter de petits objets dans des images prises par drone.
Une étude montre comment un récit injecté dans les métadonnées d’un binaire peut dégrader le triage de malwares par un modèle de langage.
Le cadre théorique des uniform AMMs pour contrôler la perte-versus-rééquilibrage selon le prix et le temps.
Une méthode de dimensionnement fondée sur la charge, les limites et les mesures plutôt que sur un classement de fournisseurs.
Une approche en deux étapes pour éviter que l’optimisation de la recherche ne dégrade le raisonnement des embeddings.
Pourquoi la complexité du code produit peut masquer la difficulté réelle d’une tâche de génération.
Gas, estimation et confirmation : une lecture prudente des frais variables d’une transaction sur Ethereum.
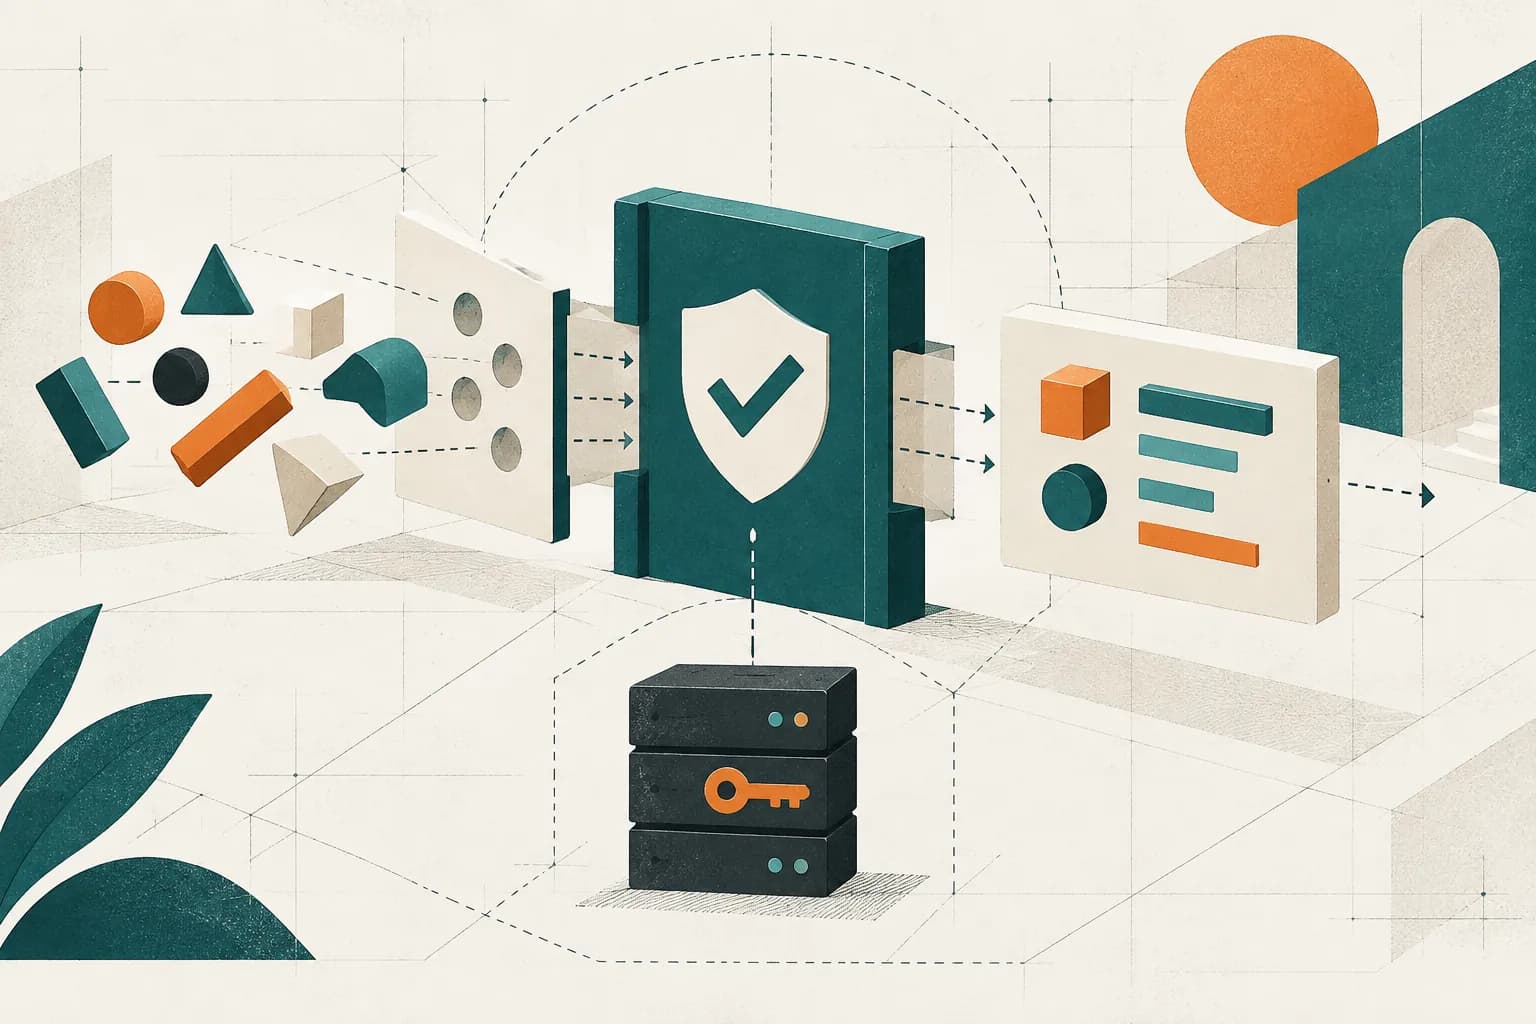
Route, validation, erreurs et secrets : les décisions qui rendent une petite API Next.js compréhensible à tester.
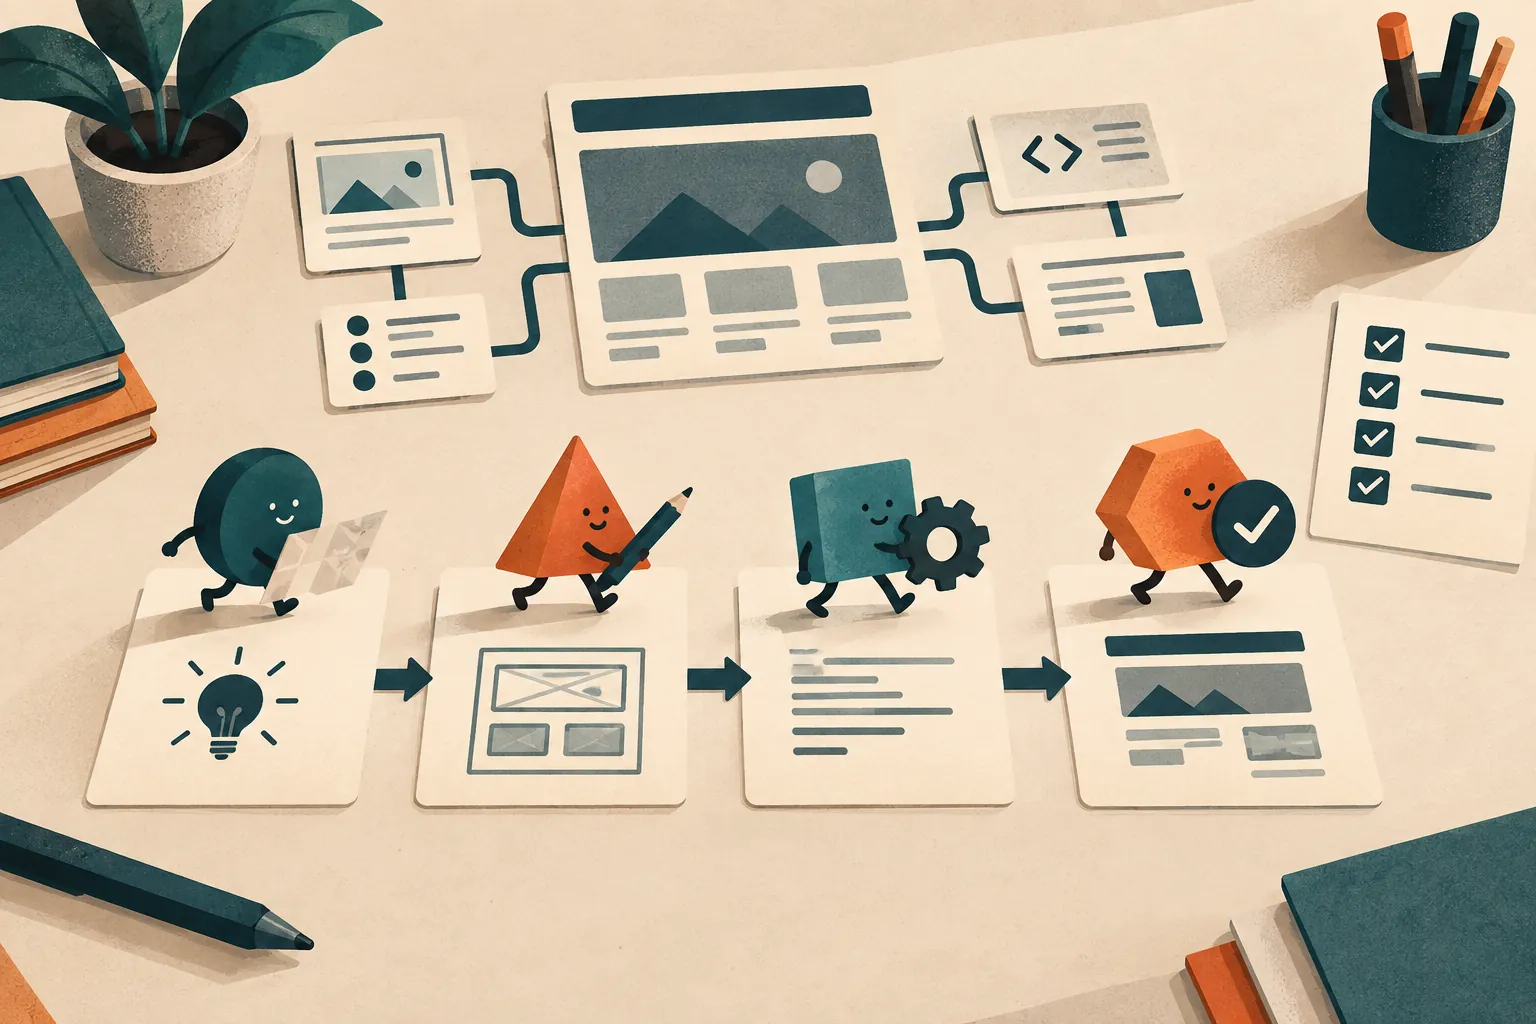
Une méthode concrète pour cadrer une évolution, charger le bon contexte et vérifier chaque tranche de code.
Une méthode en trois niveaux pour distinguer les défauts du graphe, les erreurs Cypher et les pertes de raisonnement dans un système Graph-RAG.
Une étude transforme des trajectoires web vérifiées en procédures réutilisables et montre pourquoi leur sélection compte autant que leur qualité.
Pourquoi une composante principale estimée peut être hors du sous-espace attendu ou mal orientée à l’intérieur de celui-ci.
Pourquoi une bonne performance de backtest ne suffit pas lorsque l’agent a testé de nombreuses stratégies.
Un protocole reproductible pour tester la qualité, les limites, la sécurité et le coût réel d’un outil d’IA.
Ce que propose un filtre non récursif fondé sur des pertes pondérées pour estimer des prix et une volatilité malgré un bruit de microstructure très lourd.
Une étude sur l’identification des moteurs d’inférence par leurs différences de tokenisation, d’échantillonnage et de traitement.
Une séparation simple entre configuration publique, secrets serveur, environnements et rotation.
Continuer l'exploration