
Article · VPS & hosting
Diagnostiquer l’intégrité d’un Graph-RAG cloud-native
Une méthode en trois niveaux pour distinguer les défauts du graphe, les erreurs Cypher et les pertes de raisonnement dans un système Graph-RAG.
Quand un système hébergé répond moins bien
Un système de retrieval-augmented generation ne dépend pas seulement de son modèle de langage. Dans un Graph-RAG, la réponse passe aussi par un graphe de connaissances, une requête structurée et une chaîne d’accès aux données. Si cette chaîne se dégrade, la réponse finale peut devenir moins fiable alors même que le modèle semble continuer à raisonner correctement.
Le preprint de Shuai Yan, Yuhang Wu, Xiaodong Huang et Ke Wang étudie précisément ce problème dans un environnement de bases de données cloud-native. Son titre, Decoupling Error Attribution in Cloud-Native Graph-RAG: A Data Integrity Diagnostic Framework, annonce l’idée centrale : ne pas traiter toute baisse de performance comme une seule erreur de modèle. Les auteurs séparent trois sources : la qualité du Knowledge Graph, la génération de requêtes Cypher et le raisonnement effectué à partir des preuves récupérées.
Cette distinction est utile pour une application hébergée sur un serveur ou un VPS. Une panne de synchronisation, une écriture concurrente ou une relation manquante n’appellent pas le même diagnostic qu’une requête mal générée. Si l’on mesure uniquement la réponse finale, ces causes se mélangent et l’équipe risque de corriger le mauvais composant.
Le problème de la boîte noire
Une évaluation de bout en bout peut dire qu’une question a reçu une mauvaise réponse. Elle ne dit pas toujours pourquoi. Le système peut avoir perdu le chemin dans le graphe, produit une requête Cypher incorrecte ou reçu une preuve correcte mais mal interprétée par le modèle. Dans une architecture distribuée, la situation est encore plus difficile à lire : plusieurs couches évoluent indépendamment et les données peuvent traverser différents nœuds de stockage.
Les auteurs partent de cette limite. Ils construisent un protocole qui conserve une partie de la chaîne fixe tout en faisant varier une seule source d’erreur à la fois. Le but n’est pas de prétendre que les trois causes sont toujours parfaitement indépendantes dans la production. Il s’agit de créer des points de comparaison qui rendent leur contribution mesurable.
Trois niveaux de diagnostic
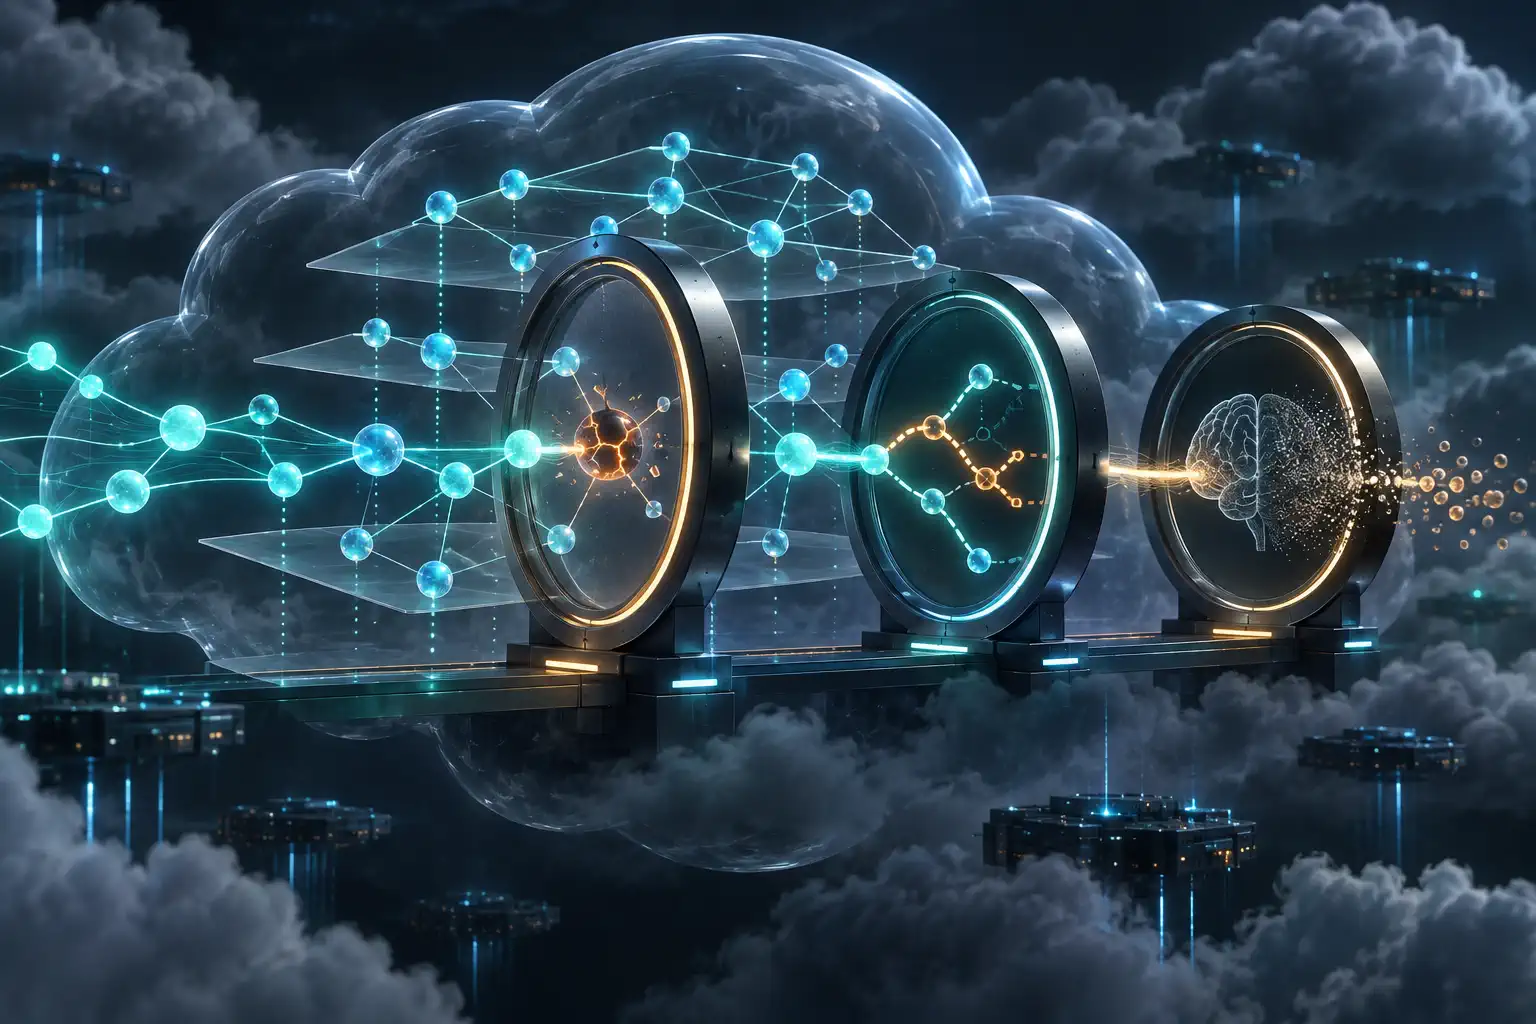
Le premier niveau est appelé Oracle Evidence. Une requête Cypher de référence est exécutée sur un graphe propre, puis son résultat est transformé en preuve textuelle pour le modèle. Cette configuration cherche à mesurer la capacité de raisonnement lorsque la provenance des données est idéale. Elle sert de plafond de comparaison.
Le deuxième niveau est Oracle Cypher. La même requête de référence est exécutée sur un graphe défectueux. La génération de requête n’est donc plus une variable : la différence avec le premier niveau rend visible l’effet de la qualité du graphe et de l’intégrité des chemins de récupération.
Le troisième niveau est l’évaluation End-to-End. Le modèle doit générer la requête Cypher et récupérer les résultats sur un graphe dégradé. Ce niveau se rapproche davantage de l’usage complet, mais il est aussi le moins explicatif pris isolément. Le protocole permet de comparer les trois niveaux pour attribuer la perte observée.
Cette construction est intéressante pour un service hébergé : elle sépare l’état des données, la couche de requêtage et la couche de génération. Un tableau de bord peut ainsi signaler qu’un graphe est devenu instable sans accuser automatiquement le modèle. Inversement, une baisse qui apparaît déjà avec la requête de référence indique que l’infrastructure de données mérite l’attention.
Des défauts injectés pour tester les limites
L’expérience utilise un graphe spatio-temporel consacré à l’environnement du sud-est du Tibet. Les auteurs construisent un graphe propre, puis huit variantes défectueuses. Chaque variante reçoit un type de défaut distinct, injecté à un taux fixe de 20 %. Ce taux élevé est présenté comme un stress test destiné à explorer les limites du système, et non comme une estimation de la fréquence quotidienne des incidents.
Les défauts couvrent notamment la sparsité structurelle, le bruit structurel, la dérive temporelle, les lacunes de preuve, les artefacts de motifs, le bruit factuel, les contradictions logiques et la corruption numérique. Certains représentent des problèmes de topologie : une relation supprimée ou redirigée peut interrompre un chemin de requête. D’autres touchent les attributs des nœuds et peuvent pousser le raisonnement vers une conclusion incompatible avec les valeurs attendues.
Le mapping proposé entre défaut logique et incident cloud-native est particulièrement parlant pour l’hébergement. Une perte partielle de shard peut se manifester comme une rupture de connectivité dans le graphe. Un retard de réplication peut produire une dérive temporelle. Une anomalie d’ingestion peut introduire une valeur numérique erronée. Le test reste artificiel, mais il donne des cas contrôlés pour examiner la propagation d’un défaut.
Les expériences utilisent aussi le mécanisme multi-database de Neo4j afin de séparer logiquement les conditions expérimentales. Cette séparation vise l’isolement des données, pas une mesure d’isolation de performance. Il faut donc éviter de transformer ce détail en promesse générale sur tous les déploiements Neo4j ou toutes les configurations VPS.
Les résultats rapportés
Sur le graphe propre, l’exactitude de référence annoncée pour la couche Oracle Cypher est de 0,93. Lorsque les défauts structurels sont introduits, l’exactitude peut descendre jusqu’à 0,39. Le résultat soutient l’idée que l’intégrité du graphe est un goulot d’étranglement majeur dans cette expérience, devant la seule capacité de raisonnement du modèle.
Les auteurs décrivent également un phénomène qu’ils nomment Parametric Knowledge Masking Effect. Lorsque le chemin de récupération est cassé, le modèle peut parfois compenser avec une information mémorisée dans ses paramètres. La réponse semble alors stable, alors que la preuve fournie par le graphe s’est détériorée. Selon le résumé et les résultats rapportés, ce masquage réduit de plus de 70 % l’erreur apparente liée à la génération de requête, ce qui peut dissimuler une dégradation du stockage.
Cette observation mérite une lecture prudente. Une réponse plausible n’est pas nécessairement une réponse correctement récupérée. Pour un service de connaissance, le risque n’est pas limité à une phrase fausse visible immédiatement. Une compensation paramétrique peut aussi supprimer la trace du défaut et créer des faux négatifs dans la surveillance automatisée : le système ne déclenche pas d’alerte parce que le modèle produit encore quelque chose de convaincant.
La robustesse varie également selon les questions. La comparaison E2E et Oracle Cypher montre davantage de questions dans la classe de stabilité complète pour E2E, tandis que la couche Oracle Cypher révèle davantage de questions à faible stabilité. Dans l’expérience, les classes moyenne et faible représentent ensemble 57 % du jeu de données. Ces proportions décrivent ce protocole précis et ne constituent pas une mesure universelle de la fiabilité d’un Graph-RAG.
Ce que cela change pour un VPS
Sur un VPS, la tentation est forte de surveiller principalement la disponibilité : processus actif, mémoire libre, réponse HTTP et charge CPU. Ces indicateurs restent nécessaires, mais ils ne disent pas si les relations du graphe sont encore exploitables. Un service peut répondre rapidement tout en renvoyant des preuves incomplètes.
Le cadre du preprint suggère une observabilité en trois plans. Un premier contrôle exécute périodiquement des requêtes de référence sur une base connue et vérifie les chemins attendus. Un deuxième compare le résultat d’une requête de référence avec celui d’une requête générée. Un troisième mesure la réponse finale du modèle. Cette séparation aide à localiser la dérive sans prétendre que chaque alerte identifie seule la cause racine.
Une vérification utile doit conserver la provenance. Pour chaque réponse de contrôle, on peut enregistrer l’identifiant de la question, la version du graphe, la requête exécutée, les nœuds et relations retournés, ainsi que le niveau de diagnostic utilisé. Les journaux ne doivent pas être confondus avec la preuve complète : ils doivent permettre de retrouver la donnée pertinente sans recopier inutilement des informations sensibles.
Le déploiement doit aussi distinguer le stress test de la surveillance quotidienne. Les défauts injectés à 20 % dans l’expérience forcent une situation extrême. Ils peuvent révéler une fragilité structurelle, mais ils ne donnent pas directement le seuil d’alerte à appliquer en production. Une équipe doit calibrer ses contrôles sur ses propres données, ses délais de réplication et ses procédures de restauration.
Limites et statut de la publication
Le travail étudie un graphe écologique, un protocole de défauts contrôlés et une configuration expérimentale particulière. Il ne prouve pas que chaque base cloud-native subira les mêmes baisses ni que le mécanisme de masquage aura la même ampleur avec un autre modèle, un autre domaine ou un autre taux de défaut.
La couche de jugement, le jeu de questions et la représentation des preuves influencent aussi les résultats. Une mise en production doit compléter l’approche par des tests de restauration, des contrôles de cohérence métier et une comparaison avec des données de référence indépendantes. Il faut enfin vérifier la licence, la sécurité et les exigences de confidentialité du graphe avant tout déploiement.
Cette publication est un preprint ArXiv, pas une validation par les pairs. Les nombres et les mécanismes décrits doivent être attribués aux auteurs et reproduits avant de devenir des seuils opérationnels. Son apport principal est méthodologique : rendre visible la différence entre un modèle qui raisonne mal, une requête qui récupère mal et un graphe qui ne contient plus la preuve attendue.
Source
Shuai Yan, Yuhang Wu, Xiaodong Huang et Ke Wang, « Decoupling Error Attribution in Cloud-Native Graph-RAG: A Data Integrity Diagnostic Framework », ArXiv 2609.13324v1 : résumé et preprint, PDF.