
Guide · IA & agents
PageRecall : diagnostiquer les pages manquantes avant de corriger le lecteur
Une méthode pour séparer récupération d’articles, sélection de pages et qualité des citations, à partir du diagnostic PageRecall.
La question à isoler
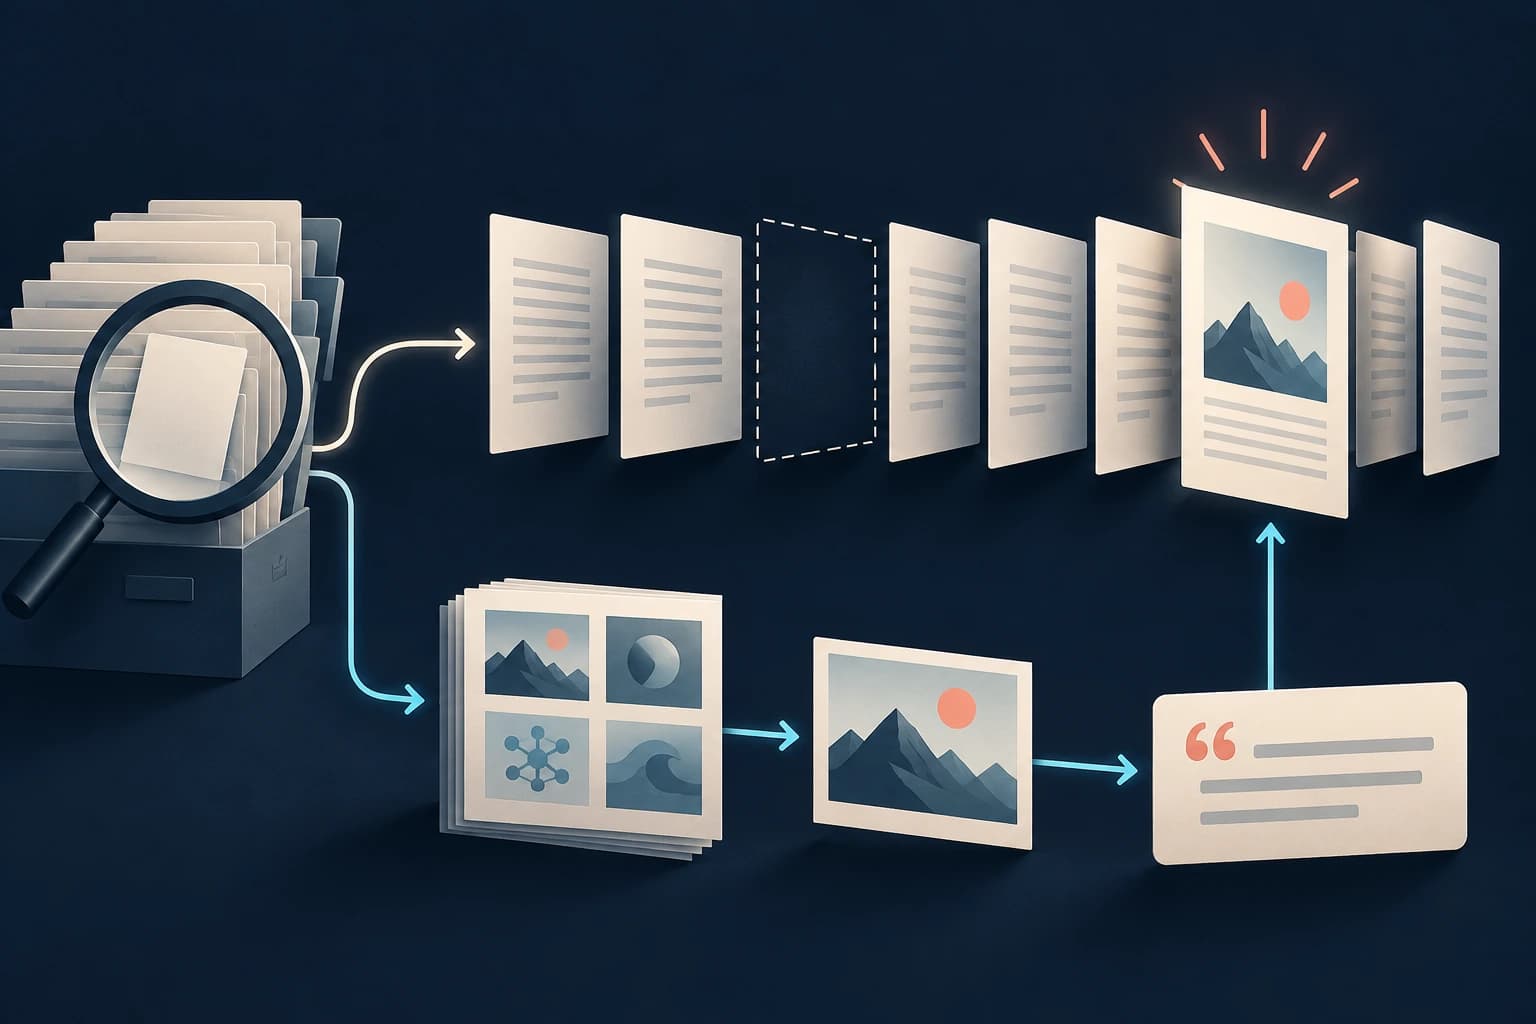
Lorsque le bon article est retrouvé mais que la réponse cite une mauvaise page, trois causes restent possibles : la page n’a pas été montrée, le lecteur l’a mal comprise ou la citation utilise une autre version du document. PageRecall sépare ces étapes au lieu de résumer tout le pipeline par un score final.
Le protocole localise d’abord les couples question–article pour lesquels l’article de référence a été récupéré et parsé. Sur le développement étudié, 55 questions produisent 97 unités de ce type.
Construire une mesure conditionnelle
Pour chaque unité, noter les pages de référence et celles effectivement présentées. Calculer ensuite la proportion de pages attendues visibles, puis contrôler les citations émises.
Le sélecteur initial BM25 top-4 atteint 52,6 % de rappel moyen des pages de référence. Lorsque la bonne page est montrée, 45 des 48 localisateurs émis sont corrects. Il serait trompeur de présenter ce dernier pourcentage comme la précision globale du système : il est conditionné à une sélection préalable favorable.
Examiner les chemins indirects
Le papier explique plusieurs citations correctes alors que la page n’était pas sélectionnée : un index de légendes fournissait les identifiants de figures et tableaux ainsi que leur localisation. Ce canal pouvait permettre de citer un objet sans en lire la page.
La fiche de diagnostic doit donc décrire toutes les informations visibles par le modèle. Une citation correcte ne prouve pas à elle seule la consultation du passage invoqué.
Comparer le filtrage à une référence simple
Les auteurs constatent que les documents étudiés tiennent généralement dans la fenêtre de contexte et choisissent de montrer toutes leurs pages. Cette solution atteint mécaniquement un rappel de sélection de 100 % ; elle n’implique pas 100 % de réponses exactes.
Le papier précise aussi qu’une comparaison dense utilisait seulement les premiers 2 000 caractères des pages, contre les pages complètes pour BM25. Cette ligne ne doit pas servir de comparaison équitable entre familles de moteurs.
Contrôles à conserver
Mesurer le coût et la taille des documents avant de généraliser l’envoi intégral. Vérifier les versions des PDF et les équations absentes de leur couche texte. Distinguer un localisateur valide d’une affirmation réellement soutenue par le texte brut.
Les effectifs restent petits et plusieurs réglages sont ajustés au développement. La reproductibilité exacte dépend aussi d’un cache de réponses, le modèle fermé n’exposant pas de graine. La présente fiche s’appuie sur des passages locaux et les sections officielles consacrées à la sélection et aux limites ; elle n’atteste pas une reproduction de PageRecall.
Source et statut
Source principale : PageRecall: Measuring Page Selection in Literature-Grounded Question Answering, prépublication ArXiv 2609.18154v1 · PDF. Les résultats rapportés sont ceux des auteurs ; les conseils de méthode sont une interprétation éditoriale. Publication éditoriale, sans reproduction expérimentale dans cette session.
Compléments officiels effectivement consultés : 5 Page selection is the bottleneck · Limitations. Lecture partielle ; voir les passages et limites consignés dans la frontmatter.