
Article · IA & agents
DRAG : choisir un couple recherche–génération, avec un seuil à clarifier
DRAG étudie le routage par requête entre moteurs et générateurs ; une incohérence de seuil impose de vérifier l’implémentation avant reprise.
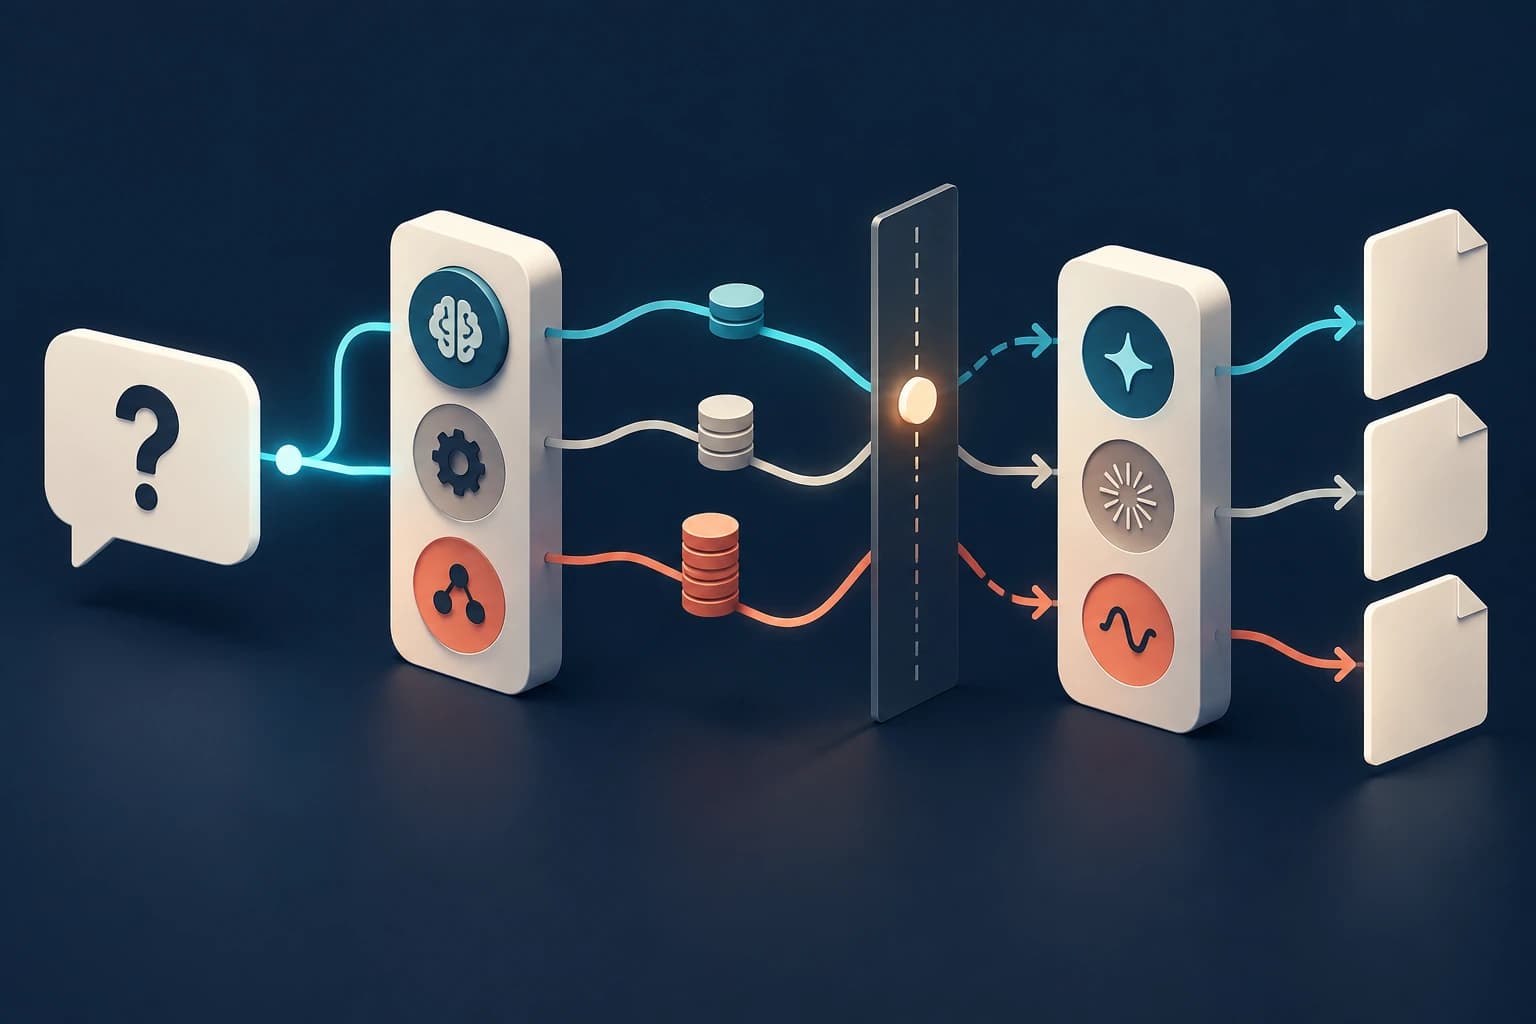
Un couple de composants, pas deux choix indépendants
DRAG part d’un constat expérimental : une configuration de recherche et de génération plus complexe ne domine pas toutes les autres pour chaque question. Le bon compromis dépend de la requête, des documents récupérés et de l’effort demandé au générateur.
Les auteurs proposent une variante fondée sur des signaux de prédiction de performance, et une variante supervisée qui apprend à sélectionner une configuration. La première choisit d’abord un moteur, puis un générateur en tenant compte du contexte obtenu.
Ce que les signaux représentent
Pour éviter d’exécuter tous les moteurs, le routage de recherche utilise des caractéristiques de la requête et du corpus disponibles avant récupération. Le choix du générateur s’appuie notamment sur la perplexité du contexte.
Une faible perplexité indique que ce texte s’accorde avec la distribution du modèle ; elle ne prouve pas que le document contient le fait demandé ni qu’il est exact. L’utiliser comme signal de routage doit donc rester distinct d’un contrôle des preuves de la réponse.
Une incohérence à résoudre avant de coder
La section officielle GPP décrit d’abord l’envoi d’un contexte à faible perplexité vers un générateur léger. L’équation de sélection utilise une condition « inférieure ou égale au seuil ». Plus bas, le paragraphe opérationnel indique de sélectionner le générateur courant lorsque la perplexité dépasse le seuil, puis d’escalader sinon.
Ces formulations donnent des directions opposées. Ce brouillon ne choisit pas une interprétation à la place des auteurs et ne fournit pas de code prétendant reproduire leur routage. La vérification du code ou une clarification est nécessaire avant toute implémentation fidèle.
Ce que les expériences soutiennent
Les évaluations portent sur TriviaQA, HotpotQA, MuSiQue et FRAMES. La variante supervisée améliore le compromis rapporté, mais l’oracle conserve un avantage. Cet oracle connaît des informations utilisées pour déterminer après coup une bonne configuration ; il n’est pas une politique disponible telle quelle en service.
La section des résultats précise aussi que les améliorations hors distribution ne sont pas toujours statistiquement significatives. Une formulation générale de « robustesse » ne doit pas faire disparaître cette réserve.
Une grille de lecture réutilisable
Comparer qualité, coût du routeur, coût de recherche et coût de génération. Examiner séparément les mauvais routages, les erreurs du générateur et les défauts de récupération. Utiliser une configuration fixe comme référence aide à déterminer si la complexité supplémentaire se justifie.
Cette grille est une interprétation éditoriale. Les sections officielles consultées ont permis d’identifier l’ambiguïté de seuil ; la lecture demeure partielle et aucune reproduction expérimentale n’a été réalisée.
Source et statut
Source principale : One Size Does Not Fit All! Dynamic Retriever and Generator Selection for RAG, prépublication ArXiv 2609.17709v1 · PDF. Les résultats rapportés sont ceux des auteurs ; les conseils de méthode sont une interprétation éditoriale. Publication éditoriale, sans reproduction expérimentale dans cette session.
Compléments officiels effectivement consultés : 4.1.2. Generator Performance Prediction (GPP) · 6.2. Dynamic vs. Static RAG Performance. Lecture partielle ; voir les passages et limites consignés dans la frontmatter.