
Guide · IA & agents
Comment créer un agent IA : trois voies, et ce qu'elles exigent vraiment
No-code, framework ou assistant généraliste : les trois voies pour créer un agent IA, leurs coûts relevés le 10 novembre 2026 et la surveillance à prévoir.
Un agent IA ne s'achète pas ; il se construit autour d'une boucle - un modèle, des outils, un critère d'arrêt - et cette boucle se paie trois fois : en abonnement, en jetons et en temps de vérification. La question « comment créer un agent IA » ne revient donc presque jamais à choisir un produit ; elle revient à décider qui portera la boucle : une plateforme qui l'exécute à la place de celui qui la configure, un framework qui laisse écrire le code, ou un assistant généraliste qui la propose déjà, avec ses plafonds et ses conditions. Les pages qui occupent aujourd'hui les premières positions répondent partiellement : billets de 2025, guides d'éditeurs qui poussent leur propre plateforme, articles d'agences qui vendent la prestation. Aucune ne place les trois voies face aux mêmes contraintes, aucune ne date un tarif, aucune ne va jusqu'à la mise en production.
Ce guide prend l'ordre inverse. Il établit d'abord ce qu'un agent fait de plus qu'un chatbot, puis décrit les trois voies avec leurs limites documentées, chiffre la facture réelle à partir des pages de tarifs officielles relevées le 10 novembre 2026, et termine par les erreurs du premier agent et la surveillance qui précède l'ouverture aux utilisateurs. Chaque montant porte sa date et sa source ; les requêtes tapées sans accent - « creer agent ia » - ramènent d'ailleurs les mêmes pages concurrentes, avec les mêmes manques.
Sommaire · quatre temps - les trois voies et ce qu'elles exigent, la facture au-delà de l'abonnement, les erreurs qui coûtent cher, la surveillance avant ouverture.
En bref : quelle voie pour quel projet
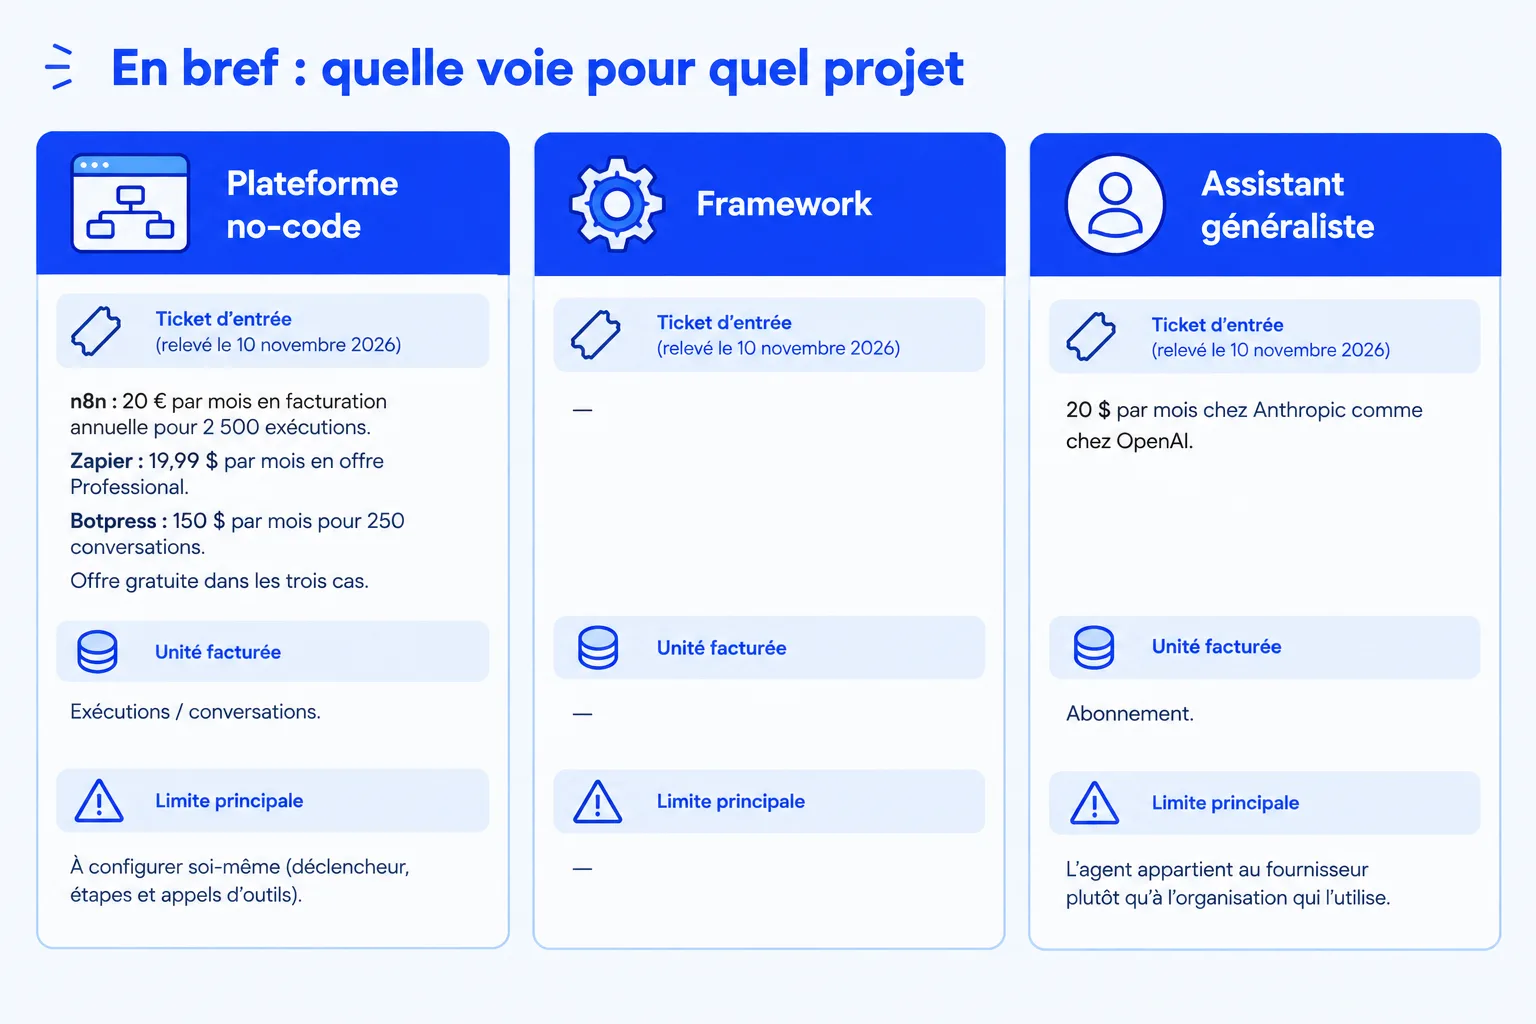
Trois phrases suffisent à orienter un projet. Si l'agent doit tenir dans un processus existant, avec cinq ou six applications déjà en place et une personne non développeuse pour le maintenir, la plateforme no-code est la voie la plus courte : on y configure un déclencheur, des étapes et des appels d'outils, et l'on paie une unité d'exécution - 20 € par mois en facturation annuelle chez n8n pour 2 500 exécutions, 19,99 $ par mois chez Zapier en offre Professional, 150 $ par mois chez Botpress pour 250 conversations, avec une offre gratuite dans les trois cas. Si le comportement de l'agent - reprise après erreur, validation humaine, état partagé entre étapes - doit être spécifié puis testé, c'est un framework qu'il faut : la licence est gratuite et ouverte, et le coût se déplace vers les jetons et le temps d'ingénierie. Si le besoin est celui d'un assistant personnel ou de petite équipe, un abonnement à un assistant généraliste couvre l'essentiel pour 20 $ par mois chez Anthropic comme chez OpenAI, à condition d'accepter que l'agent appartienne au fournisseur plutôt qu'à l'organisation qui l'utilise.
Lecture éditoriale : les trois voies ne forment pas une échelle de maturité, et passer de l'une à l'autre n'est pas une promotion. Le critère décisif est moins technique que budgétaire et organisationnel : qui maintient l'agent dans six mois, qui relit ses traces, qui paie le dépassement. Une équipe de trois personnes qui veut créer son agent IA pour un usage interne n'a pas besoin d'un framework ; une équipe qui veut créer des agents IA réutilisables par plusieurs services en aura besoin, même si la première version tient en cinquante lignes.
Les outils pris un par un, avec leurs quotas et leurs mécaniques de facturation, sont détaillés dans le comparatif des dix outils d'agents IA ; la suite de cette page s'en tient aux trois voies et à ce qu'elles imposent.
Avant de créer : ce qu'un agent IA fait qu'un chatbot ne fait pas
Un chatbot répond ; un agent agit, et la différence n'est pas de degré mais d'architecture. Anthropic, dans une note d'ingénierie publiée en décembre 2024 et révisée en octobre 2026, distingue deux familles de systèmes agentiques : les workflows, où modèles et outils sont orchestrés par des chemins de code prédéfinis, et les agents, où le modèle dirige lui-même son processus et l'usage de ses outils. Un chatbot classique ne fait ni l'un ni l'autre : il produit une réponse à un message, éventuellement enrichie par de la recherche documentaire, sans modifier d'état extérieur et sans choisir la séquence de ses propres étapes.
La conséquence pratique est double. Un agent doit tirer de son environnement une « vérité terrain » à chaque étape - le résultat d'un appel d'outil, la sortie d'une exécution de code - pour évaluer son avancement, ce qui suppose des outils décrits avec assez de précision pour être utilisables sans ambiguïté. Il doit aussi pouvoir s'arrêter : par achèvement de la tâche, par interruption humaine à un point de contrôle, ou par une condition de sortie explicite comme un nombre maximal d'itérations.
Trois questions suffisent à trancher avant d'écrire la première ligne. Le système choisit-il lui-même l'ordre de ses étapes, ou suit-il une séquence fixée à l'avance ? Dispose-t-il d'outils qui modifient un état extérieur - envoyer, réserver, écrire, supprimer ? Existe-t-il un critère d'arrêt autre que « le modèle s'est arrêté de parler » ? Trois « non » dessinent un chatbot ou un workflow, et un agent construit sur cette base coûtera plus cher que le problème qu'il prétend résoudre.
Lecture éditoriale : une part notable des produits vendus comme agents relève en réalité du workflow - la séquence est câblée, seuls les textes de chaque étape sont générés. Ce n'est pas un défaut, c'est souvent le bon choix ; le défaut serait de payer une architecture autonome, avec son coût variable et ses erreurs composées, pour un enchaînement qui n'a jamais eu besoin de décider. La distinction outil par outil, avec les cas limites, est traitée dans le guide qui compare agent IA et chatbot.
Voie 1 : les plateformes no-code, sans écrire de code
La première voie est celle que le SERP privilégie, pour une raison simple : elle produit une démonstration en une heure, sans environnement de développement. Quatre familles d'outils la composent, et chacune facture une unité différente, ce qui rend les comparaisons de prix trompeuses tant que l'unité n'est pas ramenée au travail réel.
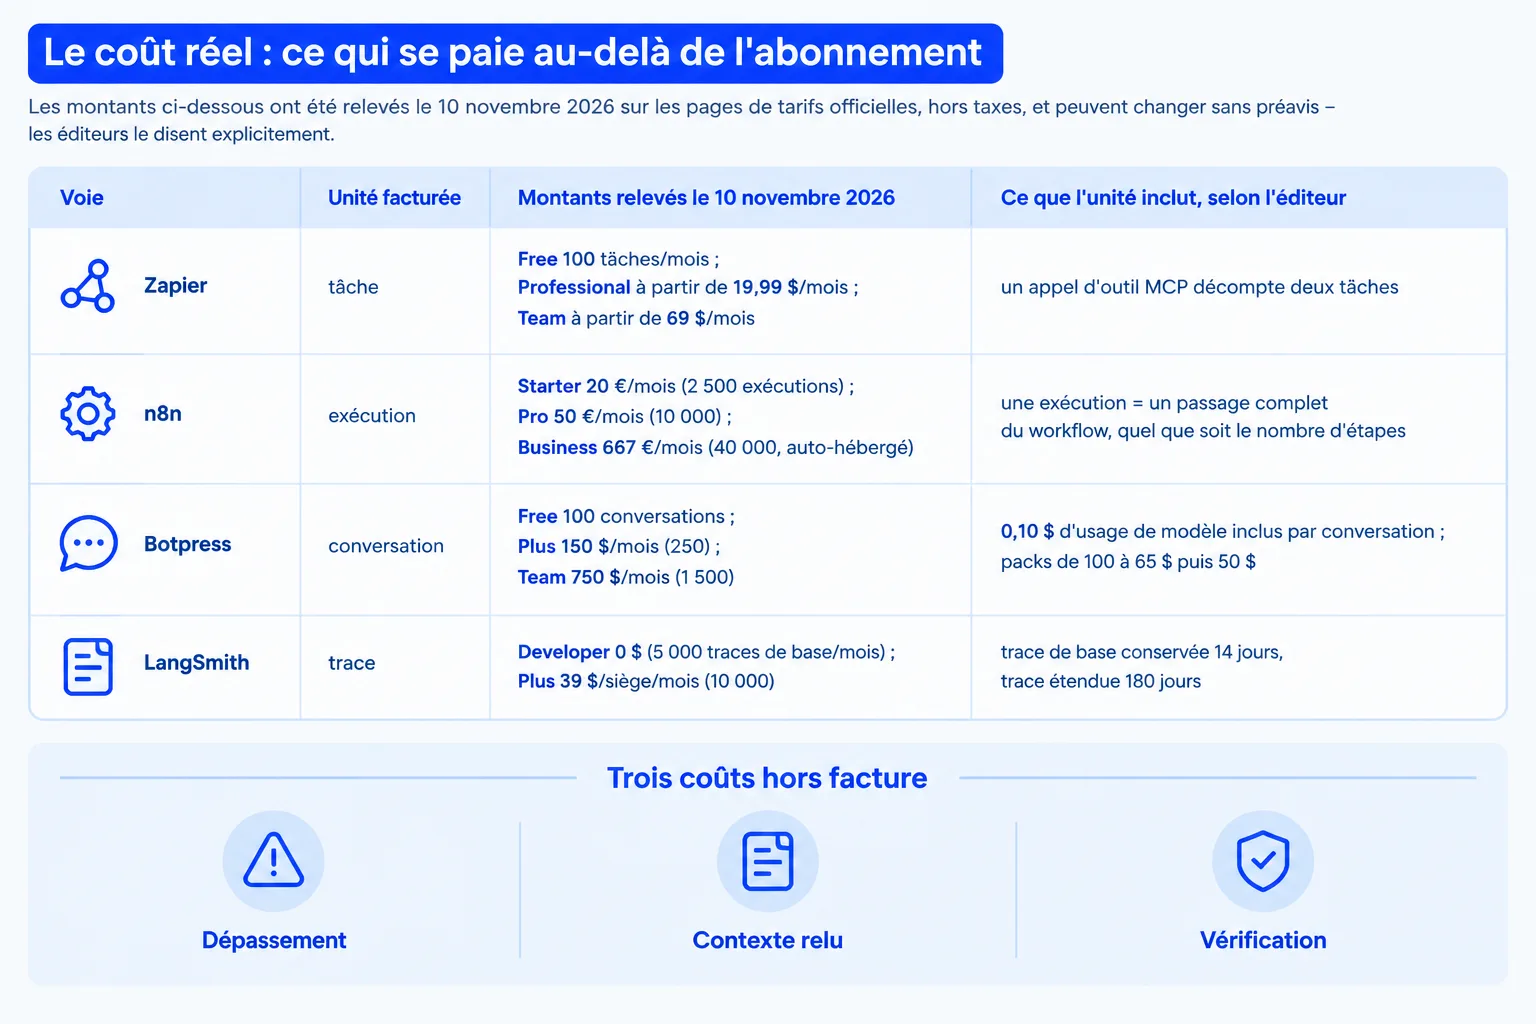
Zapier facture à la tâche : 100 tâches par mois sur l'offre gratuite, puis 19,99 $ par mois à partir de l'offre Professional et 69 $ à partir de l'offre Team, en facturation annuelle, avec un point de vigilance documenté par l'éditeur - un appel d'outil MCP décompte deux tâches. n8n facture à l'exécution : 20 € par mois en facturation annuelle pour 2 500 exécutions, 50 € pour 10 000 exécutions, 667 € pour 40 000 sur l'offre Business auto-hébergée, la Community Edition restant gratuite en auto-hébergement depuis GitHub ; une exécution correspond à un passage complet du workflow, quel que soit le nombre d'étapes qu'il contient. Botpress facture à la conversation : 100 conversations sur l'offre gratuite avec trois agents, 150 $ par mois en annuel pour 250 conversations sur l'offre Plus, 750 $ par mois pour 1 500 sur l'offre Team, les packs supplémentaires étant vendus 65 $ puis 50 $ les cent conversations, avec 0,10 $ d'usage de modèle inclus par conversation. Make, enfin, facture en crédits, unité qui varie selon les modules et les fonctions d'IA appelées.
Les limites de la voie sont stables d'une plateforme à l'autre. L'unité facturée ne correspond pas au travail d'un agent : une boucle qui interroge trois outils, reformule et vérifie avant de répondre consomme une exécution chez n8n, plusieurs tâches chez Zapier, une conversation chez Botpress, quel que soit le nombre d'allers-retours internes. L'orchestration, les journaux et les versions appartiennent à la plateforme, et les fonctions de gouvernance arrivent souvent avec l'offre la plus haute - chez n8n, le contrôle de version par Git n'est inclus que dans l'offre Enterprise. Enfin, l'exportabilité se limite rarement au workflow complet : la logique vit dans l'interface, et la quitter signifie la reconstruire.
Lecture éditoriale : la plateforme no-code reste le bon choix quand l'agent doit être maintenu par une personne qui ne code pas et quand le volume d'exécutions reste sous le premier palier payant. Au-delà, la facture ne suit plus la valeur produite mais la fréquence des boucles, et c'est précisément là que la deuxième voie devient rationnelle. La mécanique de facturation des trois plateformes d'automatisation les plus utilisées est détaillée dans le guide qui compare Zapier, Make et n8n pour les agents.
Voie 2 : les frameworks, quand le contrôle compte
La deuxième voie déplace le travail : il faut écrire du code, en échange de quoi le comportement de l'agent devient spécifiable, testable et versionné. Trois familles dominent, et leurs documentations respectives disent assez clairement à quoi elles servent.
LangGraph se présente comme un framework et un exécuteur pour agents durables et à état : les workflows y sont décrits comme des graphes d'état partagé, de nœuds et d'arêtes, avec exécution durable, streaming, interruptions pour validation humaine et persistance ; la documentation précise qu'il n'impose ni les prompts ni l'architecture de l'agent. CrewAI, sous licence MIT et fort de 60 700 étoiles sur GitHub au 10 novembre 2026, articule deux primitives : les Crews, qui laissent des agents spécialisés collaborer de façon autonome, et les Flows, qui apportent un contrôle événementiel avec état, branchements et routage. Le SDK d'agents d'OpenAI, disponible en Python et en TypeScript, s'exécute dans l'application, avec garde-fous, reprise, traçage et évaluation ; la même documentation oppose cette exécution locale à l'API d'agents, qui fait tourner un harnais géré dans le service d'OpenAI - deux modèles de responsabilité qui n'ont pas le même coût opérationnel.
Le coût d'entrée de cette voie n'est pas la licence, qui est nulle dans les trois cas. Il est double : les jetons et l'ingénierie. Les tarifs relevés le 10 novembre 2026 donnent l'ordre de grandeur d'un modèle économique : chez Anthropic, Haiku 5.5 à 0,10 $ l'entrée et 0,50 $ la sortie par million de jetons, Sonnet 5.5 à 2 $ et 10 $, Opus 5.5 à 4 $ et 20 $ ; chez OpenAI, gpt-6.1-luna à 0,10 $ et 0,50 $, gpt-6.1-sol à 2 $ et 10 $, l'outil de recherche web facturé 10 $ pour mille appels en plus des jetons. Un agent qui relit son contexte à chaque tour paie surtout de l'entrée, ce qui rend le cache de prompt décisif : chez OpenAI, l'entrée en cache de gpt-6.1-sol est à 0,10 $ contre 2 $ en entrée standard.
Anthropic formule à l'adresse des développeurs une mise en garde qui vaut pour cette voie entière : commencer par les API de modèles directement, car beaucoup de motifs tiennent en quelques lignes, et si un framework est utilisé, s'assurer de comprendre le code sous-jacent, les frameworks ajoutant des couches d'abstraction qui masquent prompts et réponses et compliquent le débogage. La même note rappelle que l'autonomie a un prix - coûts plus élevés, erreurs qui se composent - et recommande des tests étendus en environnement isolé.
Cas documenté, sans mesure comparative. L'agent qui a servi de banc de travail pour cette page a été construit avec Claude Code et Codex, à partir de gabarits et de frameworks trouvés sur GitHub. Ce cas ne vaut pas test : aucun temps de construction n'a été chronométré, aucun coût par tâche n'a été isolé, aucun modèle n'a été mis en concurrence sur une tâche identique, aucune campagne d'évaluation n'a été conduite, et aucune conclusion chiffrée n'en est tirée. Ce qu'il documente est plus étroit et se répète d'un gabarit à l'autre : la distance entre un gabarit qui s'installe et un agent qui tourne se mesure en relectures, pas en générations. Les gabarits imposent une architecture, des conventions de nommage et des dépendances qu'il faut lire avant de les modifier, et les assistants de code accélèrent cette lecture sans la remplacer. C'est un argument pour la deuxième voie, pas une preuve de supériorité : le contrôle se paie en compréhension, et la compréhension ne se délègue pas entièrement.
Les deux portes d'entrée pratiques de cette voie sont déjà balisées : un guide pas à pas pour créer un agent en Python avec le SDK d'OpenAI, et un panorama des frameworks d'agents IA avec leurs cas d'usage respectifs.
Voie 3 : les assistants généralistes et leurs limites
La troisième voie est la plus utilisée en pratique et la moins traitée sérieusement par les concurrents : confier l'agent à un assistant généraliste déjà installé, qui sait appeler des outils, lire des fichiers et exécuter du code. Les tarifs relevés le 10 novembre 2026 sont simples à énoncer. Chez Anthropic, l'offre Pro coûte 20 $ par mois en facturation mensuelle, 17 $ en annuel, Max 100 $, Ultra 200 $, et Claude Code est inclus dans toutes les offres payantes ; la documentation précise que l'activité dans le terminal et les conversations puisent dans le même quota. Chez OpenAI, l'offre Free est à 0 $, Go à 8 $, Plus à 20 $, Pro à partir de 100 $ avec des paliers à 100, 200 et 500 $, Business à 20 $ par utilisateur et par mois en annuel, 25 $ en mensuel, Codex étant inclus dans toutes ces offres.
La première limite est celle du quota, et elle est explicitement assumée par les éditeurs : les estimations publiées pour Codex donnent, sur l'offre Plus, de 15 à 160 messages locaux par tranche de cinq heures selon le modèle, de 350 à 3 000 avec le modèle le plus léger, en précisant que ces chiffres ne sont pas des limites fixes. Traduire cela en nombre de tâches terminées est impossible sans mesure sur le cas réel, et c'est précisément ce que l'abonnement ne fournit pas.
La deuxième limite est l'absence de propriété : l'orchestration, les journaux détaillés, la politique de rétention et le choix du modèle restent du ressort du fournisseur, qui les fait évoluer à son rythme - la documentation d'OpenAI indique par exemple le retrait de GPT-5.5 de Codex avec connexion ChatGPT au 14 octobre 2026 pour les sessions authentifiées par abonnement. La troisième est l'exportabilité : ce qui a été construit comme instructions, compétences ou connecteurs se transporte mal vers un autre fournisseur.
Lecture éditoriale : la frontière entre cette voie et la précédente s'efface par le bas, puisque les assistants savent désormais exécuter du code, appeler des serveurs MCP et planifier des tâches. Ce qui reste distinctif n'est pas la capacité mais la responsabilité : un abonnement ne fournit ni journal exportable, ni budget par tâche, ni engagement de stabilité de modèle. Pour un usage individuel, c'est un excellent rapport ; pour un agent qui écrit dans le système d'information d'une organisation, c'est un angle mort.
Le coût réel : ce qui se paie au-delà de l'abonnement
Aucune des trois voies ne se résume à son prix d'appel, et c'est ici que la plupart des guides s'arrêtent. Les montants ci-dessous ont été relevés le 10 novembre 2026 sur les pages de tarifs officielles, hors taxes, et peuvent changer sans préavis - les éditeurs le disent explicitement.
| Voie | Unité facturée | Montants relevés le 10 novembre 2026 | Ce que l'unité inclut, selon l'éditeur |
|---|---|---|---|
| Zapier | tâche | Free 100 tâches/mois ; Professional à partir de 19,99 $/mois ; Team à partir de 69 $/mois | un appel d'outil MCP décompte deux tâches |
| n8n | exécution | Starter 20 €/mois (2 500 exécutions) ; Pro 50 €/mois (10 000) ; Business 667 €/mois (40 000, auto-hébergé) | une exécution = un passage complet du workflow, quel que soit le nombre d'étapes |
| Botpress | conversation | Free 100 conversations ; Plus 150 $/mois (250) ; Team 750 $/mois (1 500) | 0,10 $ d'usage de modèle inclus par conversation ; packs de 100 à 65 $ puis 50 $ |
| LangSmith | trace | Developer 0 $ (5 000 traces de base/mois) ; Plus 39 $/siège/mois (10 000) | trace de base conservée 14 jours, trace étendue 180 jours |
| Modèles (API) | million de jetons | Haiku 5.5 0,10 $/0,50 $ ; Sonnet 5.5 2 $/10 $ ; gpt-6.1-luna 0,10 $/0,50 $ ; gpt-6.1-sol 2 $/10 $ | entrée et sortie ; entrée en cache facturée à part, 0,10 $ chez OpenAI pour gpt-6.1-sol |
| Assistants | siège | Claude Pro 20 $/mois (17 $ en annuel), Max 100 $, Ultra 200 $ ; ChatGPT Go 8 $, Plus 20 $, Pro dès 100 $ | usage plafonné par fenêtre de cinq heures et par semaine, partagé avec les fonctions agentiques |
Trois coûts échappent à ce tableau, et ce sont eux qui décident du budget réel.
Le premier est le dépassement, dont la mécanique varie du tout au tout. Zapier bascule en facturation à la tâche dès que le plafond est atteint, sauf réglage contraire, puis met les workflows en pause au plafond maximal ; Botpress ajoute automatiquement un pack de conversations à 95 % du quota, et l'éditeur précise que ce rechargement ne peut pas être désactivé ; n8n plafonne les frais de dépassement sur ses offres Starter et Pro. Pour un agent qui boucle, ces trois comportements produisent trois factures très différentes à volume identique.
Le deuxième est le contexte relu. Un agent renvoie son historique, ses instructions et les résultats d'outils à chaque tour, et cette répétition se paie au tarif d'entrée. Les grilles rendent l'écart visible : chez Anthropic, la lecture de cache de Haiku 5.5 est facturée 0,01 $ par million de jetons contre 0,10 $ en entrée standard, l'écriture de cache 0,125 $. Chez OpenAI, l'entrée en cache de gpt-6.1-sol est à 0,10 $ contre 2 $. Un agent sans stratégie de cache peut donc coûter plusieurs fois ce qu'annonce le calcul naïf.
Le troisième coût n'apparaît sur aucune facture : la vérification. Relire les sorties, corriger les appels d'outils mal formés, comparer deux versions de prompt, instrumenter les traces - ce temps est le premier poste d'un projet d'agent, et il ne diminue pas avec le prix de l'abonnement. Davantage d'agents ne réduit pas ce temps. Davantage de contexte relu ne rend pas une décision plus juste. Davantage de quota ne remplace pas une évaluation.
Les erreurs qui coûtent le plus cher au premier agent
Les échecs du premier agent se ressemblent, et la documentation des éditeurs les décrit souvent mieux que les billets d'opinion.
La première erreur est de donner à l'agent tout l'outillage disponible. La documentation de Codex recommande explicitement de limiter le nombre de serveurs MCP, chaque serveur ajoutant du contexte aux messages et consommant une part du quota, et de réduire la taille des fichiers d'instructions projet. Un agent doté de quinze outils choisit moins bien qu'un agent qui en a trois, et son coût par tour augmente mécaniquement.
La deuxième est de construire un agent là où un workflow suffisait. Anthropic le formule sans détour : chercher la solution la plus simple, n'augmenter la complexité que lorsqu'elle améliore démontrablement le résultat, et se souvenir que les systèmes agentiques échangent latence et coût contre performance. Un agent pour trier des messages selon trois catégories fixes est un workflow déguisé, payé au prix d'un agent.
La troisième est de livrer sans chemin d'erreur. Un appel d'outil qui échoue, un format de sortie invalide, une réponse vide : sans reprise, sans garde-fou et sans point d'arrêt humain, l'agent continue et propage l'erreur. Les frameworks documentent ces primitives - interruptions et persistance chez LangGraph, garde-fous et reprise chez le SDK d'OpenAI, validation humaine chez CrewAI - mais elles ne servent que si elles sont branchées avant la mise en production, pas après le premier incident.
La quatrième est de perdre la version. Un prompt modifié dans l'interface d'une plateforme sans historique est un comportement non reproductible ; chez n8n, le contrôle de version par Git n'est inclus que dans l'offre Enterprise, ce qui invite à exporter les définitions de workflow vers un dépôt dès la première version stable.
La cinquième est de mesurer la démonstration au lieu du résultat : « l'agent répond » n'est pas un critère, « l'agent termine la tâche sans intervention sur les cas prévus » en est un, et il suppose un jeu de cas et un décompte.
Lecture éditoriale : ces cinq erreurs se hiérarchisent par coût de correction. La première et la quatrième se corrigent en une journée ; la deuxième impose de reconstruire ; la troisième se paie en incidents ; la cinquième prive simplement de toute possibilité de savoir si l'agent s'est amélioré ou dégradé.
Tester et surveiller : ce qu'il faut mesurer avant d'ouvrir aux utilisateurs
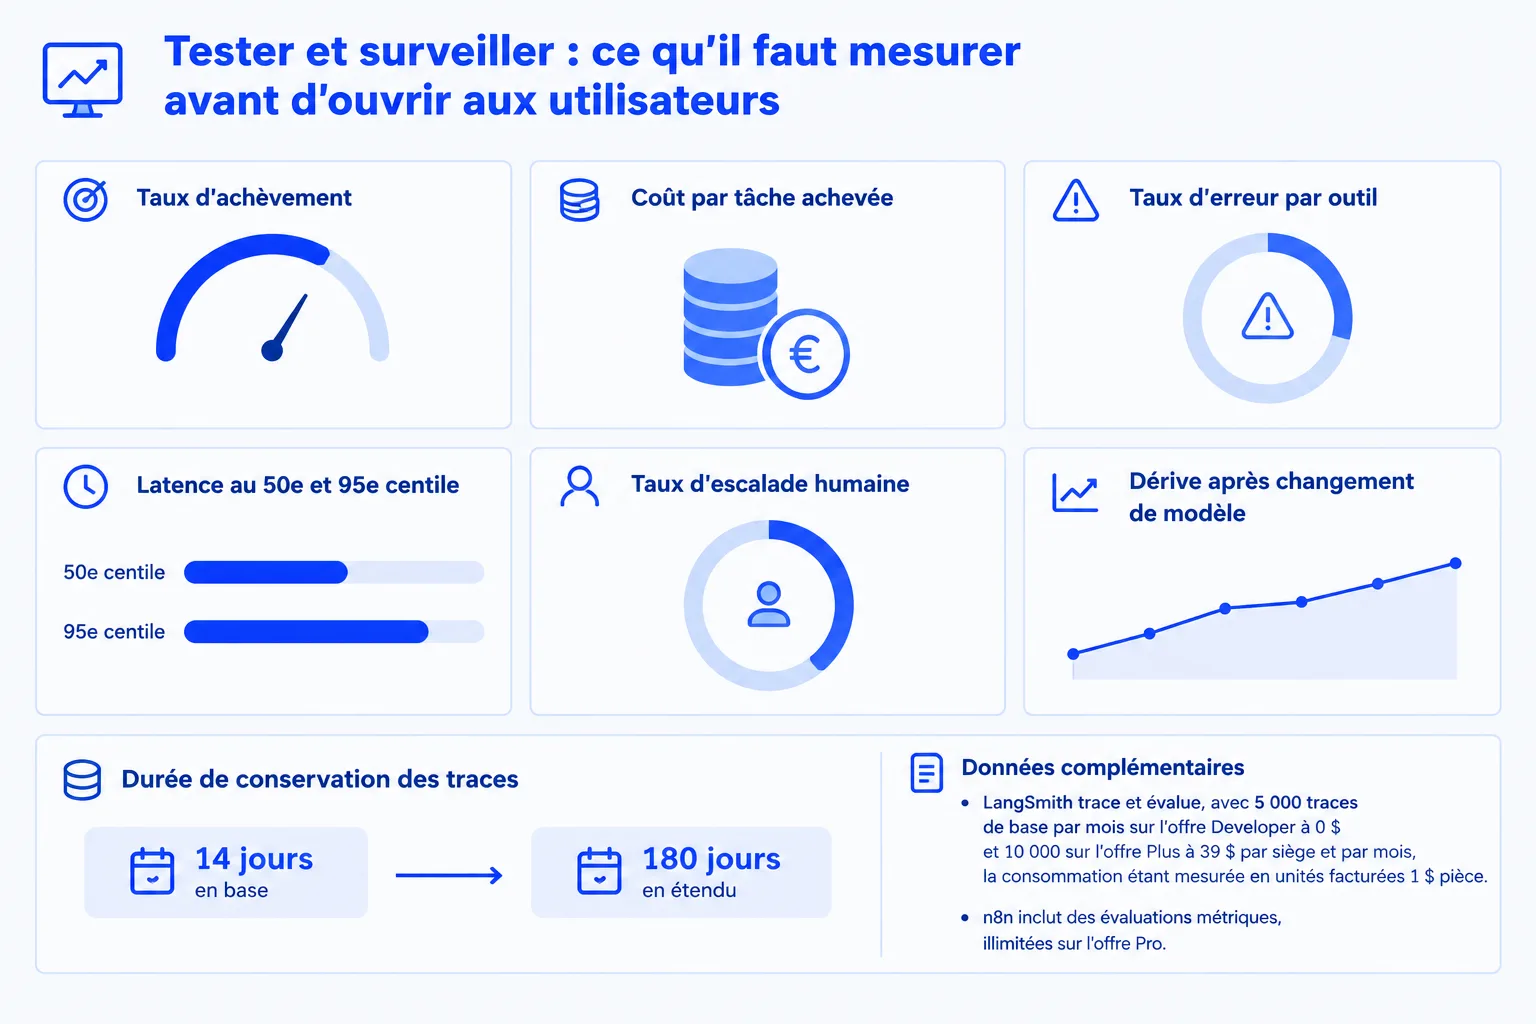
Un agent qui n'est pas mesuré n'est pas en production, il est en démonstration prolongée. La difficulté n'est pas de choisir des métriques mais de conserver de quoi les comparer : une trace de base est conservée 14 jours chez LangSmith, une trace étendue 180 jours, ce qui signifie que la référence d'un mois disparaît avant qu'on puisse la comparer au mois suivant si rien n'est exporté.
Six mesures suffisent à couvrir le premier mois. Le taux d'achèvement de la tâche sur un jeu de cas figé, compté à la main si nécessaire. Le coût par tâche achevée, obtenu en additionnant les jetons consommés au tarif relevé, l'unité de plateforme consommée et, le cas échéant, la trace. Le taux d'erreur par outil, pour identifier l'outil qui casse plutôt que l'agent qui échoue. La latence au 50ᵉ et au 95ᵉ centile, parce qu'un agent lent est un agent abandonné. Le taux d'escalade humaine, qui dit si l'agent travaille ou s'il fait travailler les autres. Et la dérive après changement de modèle ou de prompt, seule mesure capable de détecter une régression silencieuse.
Les outils existent et sont tarifés. LangSmith trace et évalue, avec 5 000 traces de base par mois sur l'offre Developer à 0 $ et 10 000 sur l'offre Plus à 39 $ par siège et par mois, la consommation étant mesurée en unités facturées 1 $ pièce. n8n inclut des évaluations métriques, illimitées sur l'offre Pro. CrewAI expose dans son offre payante le traçage, l'OpenTelemetry et l'analyse des performances par équipe. Le SDK d'OpenAI documente le traçage et l'évaluation des workflows d'agents. La documentation de Codex renvoie à un tableau de bord d'usage, avec la recommandation explicite de le consulter une fois par semaine ou tous les quinze jours.
Lecture éditoriale : le point de bascule n'est pas l'outil mais la discipline. Une équipe qui consigne dix cas, leur résultat attendu et le coût observé dispose de plus d'information qu'une équipe qui collecte des milliers de traces sans référence. Et le cas documenté plus haut - construction avec Claude Code et Codex à partir de gabarits GitHub - ne fournit aucune de ces six mesures : il ne dit rien de la qualité de l'agent produit, seulement de la manière dont il a été assemblé. C'est exactement la distinction que ce guide veut rendre visible, et le guide complet des agents IA détaille les étapes qui entourent cette mesure.
Questions fréquentes
Faut-il savoir coder pour créer un agent IA ?
Pour la première voie, non : une plateforme no-code se configure en interface, avec un déclencheur, des étapes et des connexions d'applications. Pour la deuxième, oui, et pas seulement au niveau débutant : il faut lire du code, comprendre un état partagé et savoir instrumenter des appels. La troisième voie se situe entre les deux - l'assistant s'utilise sans coder, mais un agent qui doit écrire dans un système d'information demande des compétences en API, en droits d'accès et en formats de sortie. La question utile n'est pas « faut-il coder » mais « qui relira le code ou les traces dans six mois ».
Combien coûte le premier agent IA ?
Les montants relevés le 10 novembre 2026 donnent un plancher et un plafond. Un prototype coûte zéro en licence : n8n Community Edition auto-hébergé, CrewAI et LangGraph sont gratuits, et les offres Free de Zapier et Botpress suffisent pour une démonstration. Une mise en service réelle commence autour de 20 à 50 € par mois pour un volume faible sur une plateforme, de 20 $ par mois pour un assistant généraliste, et le coût variable d'un agent en framework dépend entièrement des jetons : à 2 $ l'entrée et 10 $ la sortie par million de jetons pour un modèle de milieu de gamme, un agent bavard coûte plus cher que son abonnement.
Quel modèle choisir pour un premier agent ?
Le moins cher qui passe les tests, et non le plus capable disponible. Les écarts de tarif sont d'un facteur vingt à quarante entre un petit modèle et un gros : 0,10 $ l'entrée chez Haiku 5.5 ou gpt-6.1-luna contre 2 $ chez Sonnet 5.5 et gpt-6.1-sol. Un agent dont la tâche est cadrée - extraire, classer, router, appeler un outil au format fixe - n'a généralement pas besoin du modèle le plus coûteux, et la bascule vers un modèle plus puissant se justifie par un taux d'échec mesuré, pas par une impression.
Pourquoi « comment creer des agents ia » et « comment créer un agent IA » renvoient-ils les mêmes pages ?
Parce que les moteurs traitent les variantes sans accent et les formes proches comme une même intention de recherche, et parce que les pages en tête visent le volume de la requête principale sans distinguer les besoins. Cela signifie aussi que la concurrence à affronter est la même sur les deux formulations : des billets de 2025 et des guides d'éditeurs qui ne datent ni leurs tarifs ni leurs limites. La distinction utile n'est pas orthographique, elle est architecturale : no-code, framework ou assistant.
Peut-on passer du no-code à un framework sans reconstruire ?
Rarement sans effort, mais le passage est possible si la logique a été isolée. Les plateformes savent exposer un agent comme outil via MCP, et les frameworks savent appeler un serveur MCP distant : c'est la voie de migration la moins coûteuse, puisque le no-code continue de porter les intégrations et le framework ne porte que la boucle de décision. Ce qui ne se migre pas, en revanche, c'est ce qui n'a jamais été écrit ailleurs que dans l'interface - les prompts, les consignes de validation et les règles de routage doivent être exportés avant que le besoin de contrôle ne devienne urgent.
Sources
Pages consultées le 10 novembre 2026.
- Anthropic, Plans & pricing - offres Pro, Max, Ultra, Team et Enterprise, tarifs API par million de jetons, inclusion de Claude Code dans les offres payantes : https://claude.com/pricing
- Anthropic, Building effective agents (publié le 19 décembre 2024, révisé le 9 octobre 2026) - distinction workflows / agents, mise en garde sur les frameworks, coûts et garde-fous : https://www.anthropic.com/research/building-effective-agents
- OpenAI, API Pricing - tarifs par million de jetons, cache d'entrée, tarification des outils : https://developers.openai.com/api/docs/pricing
- OpenAI, Pricing (ChatGPT et Codex) - offres Free, Go, Plus, Pro, Business, estimations de messages et tableau de bord d'usage : https://learn.chatgpt.com/docs/pricing
- OpenAI, Agents SDK - exécution dans l'application, API d'agents gérée, garde-fous, traçage et évaluation : https://developers.openai.com/api/docs/guides/agents/sdk
- n8n, Plans and Pricing - Starter, Pro, Business, Community Edition, unité d'exécution, contrôle de version par Git selon l'offre : https://n8n.io/pricing/
- Zapier, Plans & Pricing - offres Free, Professional, Team, agents, consommation d'un appel MCP et bascule en facturation à la tâche : https://zapier.com/pricing
- Botpress, Pricing - offres Free, Plus, Team, unité de conversation, usage de modèle inclus et rechargement automatique à 95 % : https://botpress.com/pricing
- LangChain, Pricing - offres LangSmith, traces de base et étendues, unités de facturation : https://www.langchain.com/pricing
- LangChain, LangGraph overview - graphes d'état, exécution durable, interruptions, absence de prescription d'architecture : https://docs.langchain.com/oss/python/langgraph/overview
- CrewAI, Pricing - offre gratuite et offre entreprise : https://crewai.com/pricing
- CrewAI, dépôt GitHub - licence MIT, étoiles au 10 novembre 2026, primitives Crews et Flows : https://github.com/crewAIInc/crewAI