
Article · IA & agents
SARA : transformer les raisons exprimées en signaux sans perdre leur provenance
SARA exploite des raisons positives et négatives dans la recommandation de directs ; leur collecte, leur génération et leur évaluation restent trois étapes distinctes.
Au-delà du clic
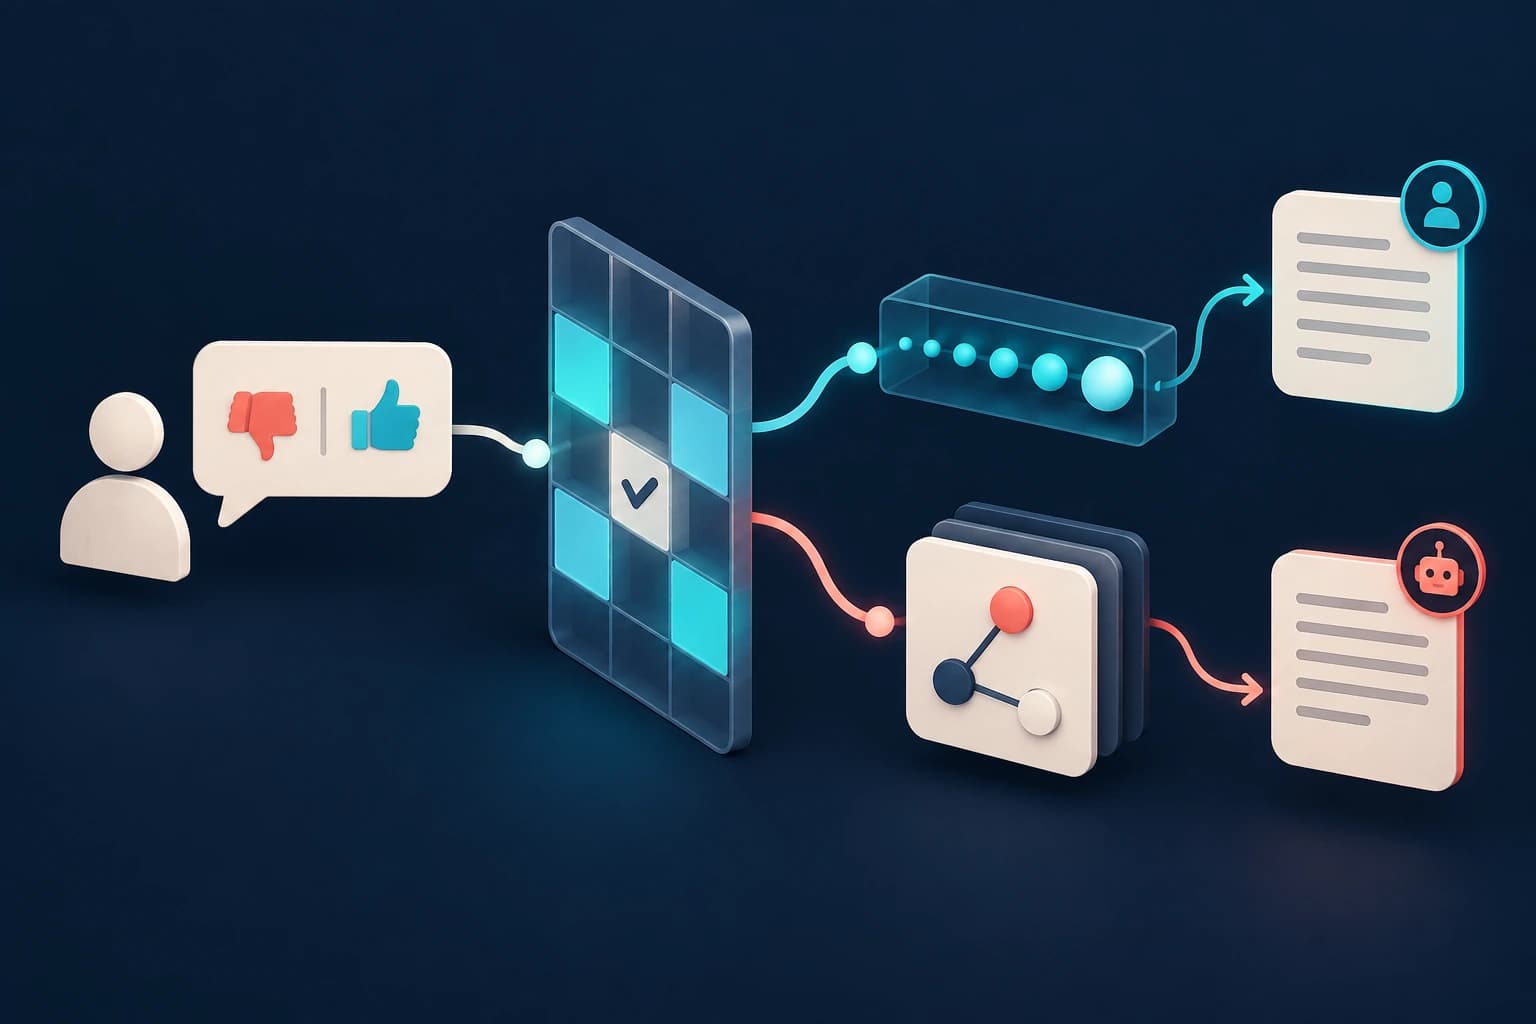
SARA cherche à exploiter les raisons qu’un utilisateur donne à son appréciation d’un direct. Un clic ou une durée de visionnage indique un comportement ; une réponse libre peut préciser ce qui plaît ou déplaît.
Le système décrit collecte d’abord une polarité positive ou négative, puis une explication ouverte. Le déclenchement intervient après un temps de visionnage et l’exposition au questionnaire reste partielle. Ces choix visent un compromis entre quantité et qualité des réponses.
La collecte façonne le signal obtenu
La section officielle indique un déclenchement après dix secondes dans la configuration retenue. Une question trop tardive peut manquer les utilisateurs qui ont quitté le direct ; une question trop précoce peut recueillir une impression encore peu formée.
Le dispositif comporte aussi une récompense conditionnée par un juge de qualité. Ces détails comptent pour interpréter le corpus : les réponses collectées résultent d’un processus d’exposition, de participation et de sélection. L’analyse éditoriale invite à conserver ces conditions avec les données plutôt qu’à traiter le corpus comme une photographie neutre de tous les utilisateurs.
Distinguer raisons exprimées et raisons générées
Le corpus de qualité ne couvre qu’une partie des créateurs. SARA-7B est adapté par apprentissage supervisé et optimisation de préférences pour générer des raisons à plus grande échelle. Le système de classement les consomme sous forme de représentations ou d’identifiants sémantiques.
Une raison générée pour un créateur ne doit pas être attribuée à un utilisateur particulier comme s’il l’avait réellement exprimée. Cette distinction de provenance est une conséquence pratique de l’architecture, pas une propriété garantie par le seul texte produit.
Évaluer le juge lui-même
Le protocole compare plusieurs évaluateurs à des annotations expertes sur un test séparé par créateur. Les dimensions incluent cohérence, pertinence, précision du propos, sécurité, polarité et soutien par le contexte.
L’erreur absolue moyenne du jugement global passe de 0,35 pour le juge en ligne à 0,20 pour le dispositif à spécialistes et revue finale, dans ce test. La référence d’accord entre experts vaut 0,12. Ces valeurs mesurent un accord avec la grille humaine, pas la vérité universelle d’une préférence.
Portée des résultats
Les auteurs rapportent des gains dans un système industriel de recommandation de directs Kuaishou, avec des essais sur une fraction du trafic. La collecte, la langue, les signaux d’engagement et les interfaces sont propres à cet environnement.
Le brouillon ne promet donc aucun gain pour un autre service. Il retient surtout la séparation entre collecte, génération et usage des raisons. Les sections officielles consultées complètent les passages locaux ; la totalité des expériences et annexes n’a pas été lue.
Source et statut
Source principale : Scaling Articulated Rationales for MLLM-based Recommendation, prépublication ArXiv 2609.17639v1 · PDF. Les résultats rapportés sont ceux des auteurs ; les conseils de méthode sont une interprétation éditoriale. Publication éditoriale, sans reproduction expérimentale dans cette session.
Compléments officiels effectivement consultés : 2.2 Online Collection · 4.4 Evaluator Validation. Lecture partielle ; voir les passages et limites consignés dans la frontmatter.