
Article · IA & agents
ReliGRec : un score de risque proxy ne prouve ni fraude ni meilleur routage
ReliGRec combine représentations temporelles et routage de prompts, mais ses contrôles ne démontrent pas l’avantage du routage sur la meilleure politique uniforme.
Ce que le mot « risque » désigne ici
ReliGRec étudie la recommandation générative avec un score de risque appris à partir de signaux faibles. La définition officielle précise que les étiquettes caractérisent un écart proxy dans les interactions ; elles ne désignent pas des identités malveillantes vérifiées.
Cette distinction est centrale. Une bonne prédiction de ces étiquettes ne doit pas être présentée comme une détection de fraude. Le score est une variable interne à un protocole, dont le sens dépend de la manière dont les labels ont été construits.
Deux représentations, puis un choix de prompt
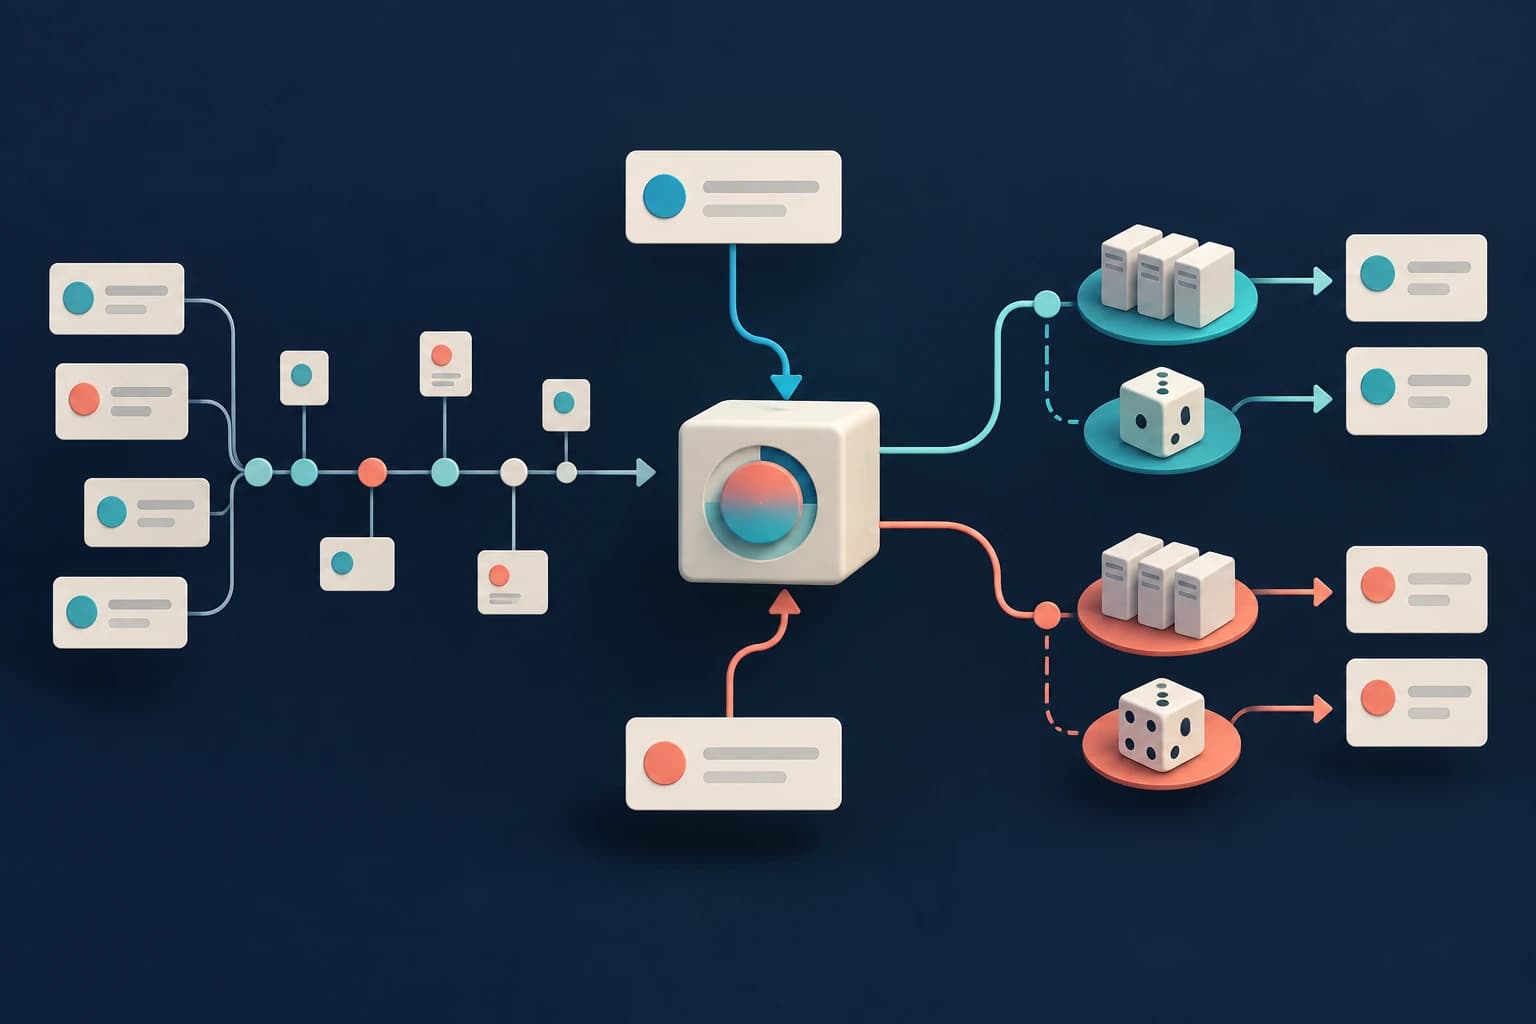
Le système combine une représentation des préférences séquentielles et une représentation collaborative temporelle. Il utilise aussi des identifiants sémantiques d’éléments pour la génération de recommandations.
Le score obtenu choisit entre un prompt simple et un prompt prudent avant la génération. Cette chaîne contient plusieurs composants : améliorer la recommandation du système complet ne permet pas d’attribuer automatiquement le gain au routeur.
Ce que disent les résultats globaux
Sur Beauty, les auteurs rapportent des résultats favorables dans la comparaison de systèmes complets. Sur Yelp, ReliGRec est proche de la meilleure référence et ne domine pas toutes les métriques.
Le papier souligne lui-même que les modèles, tokeniseurs et autres composants peuvent contribuer aux écarts. Une comparaison entre architectures complètes n’isole pas l’efficacité d’un seul mécanisme.
Le contrôle de routage change la conclusion
La section officielle compare les prompts toujours simples, toujours prudents, un routage aléatoire de même proportion et le routage guidé par le risque, en gardant le même checkpoint et les mêmes utilisateurs.
Le NDCG@10 rapporté vaut 0,0370 pour le routage guidé, contre 0,0379 pour le prompt toujours simple. Le résultat guidé se situe aussi dans l’intervalle à 95 % du routage aléatoire de même proportion. Ces observations ne démontrent donc pas un avantage du score de risque pour orienter les prompts.
Ne pas lire une fréquence de route comme une prévalence
La route prudente reçoit 66,9 % des requêtes dans ce test. Le score n’est pas calibré et l’apprentissage pondère la classe positive : cette fraction ne mesure pas la proportion de personnes à risque dans une population.
Pour examiner un routeur similaire, conserver la meilleure politique uniforme et un contrôle aléatoire de même coût ou proportion. Mesurer séparément précision du proxy, qualité de recommandation et coût. Cette proposition méthodologique découle d’une lecture ciblée locale complétée par les sections officielles de définition et d’analyse du routage ; elle ne constitue pas une reproduction.
Source et statut
Source principale : ReliGRec: Reliability-Oriented LLM-Based Generative Recommendation via User-Risk-Aware Prompt Routing, prépublication ArXiv 2609.16560v1 · PDF. Les résultats rapportés sont ceux des auteurs ; les conseils de méthode sont une interprétation éditoriale. Publication éditoriale, sans reproduction expérimentale dans cette session.
Compléments officiels effectivement consultés : Problem Definition · Prompt-Routing Analysis (RQ3). Lecture partielle ; voir les passages et limites consignés dans la frontmatter.