
Guide · IA & agents
Concevoir un harness de coding agent selon le modèle et le budget
Une étude composant par composant sur la planification, l’espace d’action et la gestion du contexte des agents de code.
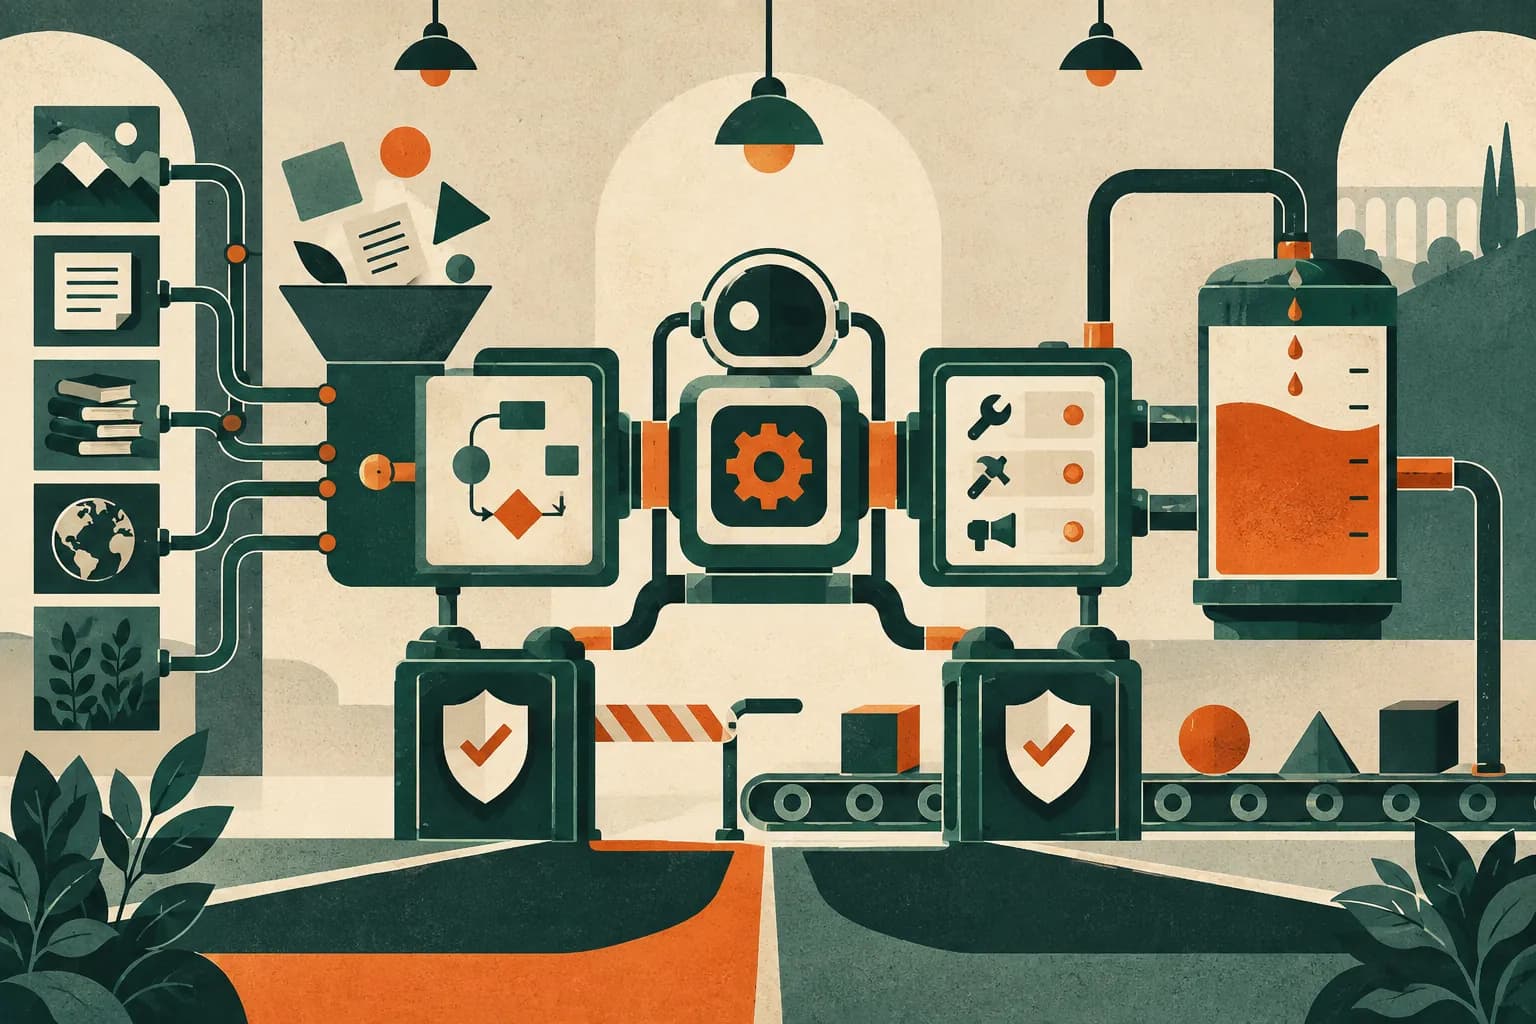
Un harness n’est pas neutre
Un coding agent ne transforme pas directement une capacité de modèle en correctif logiciel. Une boucle d’exécution choisit ce que le modèle voit, les actions qu’il peut demander, la manière dont le contexte est résumé et le moment où la tâche s’arrête. Deux modèles identiques peuvent donc obtenir des résultats différents selon leur harness.
Le preprint « An Empirical Study of Harness Design for Coding Agents » cherche à mesurer les composants séparément. Les auteurs fixent la boucle d’exécution d’un harness léger, puis font varier la planification, l’espace d’action et la gestion du contexte. Cette approche évite d’attribuer au modèle un effet qui vient en réalité de l’orchestration.
Le dispositif expérimental
L’étude couvre quatre modèles évalués sur SWE-Bench Verified et Terminal-Bench 2.1. Les auteurs comparent 176 configurations appariées, cinq stratégies de gestion du contexte, quatre budgets de fenêtre ainsi que des ablations ciblées de la planification et de l’espace d’action.
Une configuration appariée est utile parce qu’elle limite une comparaison trop vague. Si la boucle, la tâche et le modèle changent en même temps, il devient difficile de savoir pourquoi un résultat évolue. Une étude composant par composant ne supprime pas toutes les variables, mais elle rend l’explication plus contrôlable.
Gestion du contexte
Le contexte devient une contrainte lorsque l’agent lit plusieurs fichiers, exécute des tests et accumule des sorties de terminal. Le résumé du papier indique que la gestion du contexte devient plus utile lorsque le budget de fenêtre se resserre, et que son bénéfice vient surtout de la prévention des dépassements de contexte.
Parmi les stratégies comparées, l’élagage par règles avant résumé par LLM fournit l’efficacité globale la plus forte. Rendre le contenu élagué récupérable ajoute de la mécanique, mais les modèles l’utilisent rarement et le papier ne constate pas de gain d’exactitude associé. Ce résultat ne signifie pas que la récupération est toujours inutile : il indique que son coût et son usage doivent être mesurés plutôt que supposés.
Planification et espace d’action
La planification ne joue pas le même rôle selon le modèle. Elle semble servir de support d’exactitude aux modèles plus faibles, tandis qu’elle devient surtout un moyen d’économiser du coût pour les modèles plus forts, avec peu de changement de précision dans l’étude. Une équipe devrait donc mesurer le coût des étapes de planification et leur effet sur les arrêts, pas seulement leur présence.
Les outils prédéfinis améliorent la performance des modèles moins à l’aise avec Bash. À l’inverse, les modèles compétents en Bash peuvent travailler efficacement avec une interface limitée à Bash et atteindre un coût sensiblement inférieur sur les tâches centrées sur la ligne de commande. Un espace d’action plus riche n’est donc pas automatiquement meilleur.
Comment conduire un essai
Commencez par choisir quelques tâches représentatives et conservez le même modèle, dépôt et budget. Mesurez l’exactitude du correctif, le nombre de tours, le coût, les dépassements de contexte et la durée. Ajoutez ensuite une seule variante du harness. Cette méthode permet de distinguer un gain de modèle d’un gain d’orchestration.
Analysez les trajectoires, pas uniquement le résultat final. La gestion du contexte peut prolonger l’exécution sans modifier fortement le comportement. La planification peut changer l’endroit où la trajectoire s’arrête. L’espace d’action peut modifier la granularité à laquelle le code est écrit. Ces différences expliquent pourquoi deux scores finaux proches peuvent cacher des coûts et des risques différents.
Une grille de mesure
Commencez par la réussite fonctionnelle : le correctif répond-il au problème et les tests passent-ils ? Ajoutez ensuite la qualité du changement : fichiers touchés, lisibilité, régression et compatibilité. Enfin, mesurez le coût : tokens, durée, nombre d’appels, sorties de terminal et interventions humaines. Ces dimensions ne doivent pas être fusionnées trop tôt dans un score global.
Conservez les échecs avec leur cause présumée. Un dépassement de contexte n’est pas équivalent à un test mal compris, et un arrêt prématuré n’est pas équivalent à une commande impossible. Cette taxonomie peut être révisée après analyse de trajectoire, mais elle offre une base pour choisir le prochain composant à modifier.
Budget et sécurité
Un espace d’action minimal réduit parfois le coût, mais il ne suffit pas à sécuriser un agent. Les permissions de lecture, d’écriture, d’exécution et de réseau doivent être séparées. Une interface Bash seule peut être efficace sur une tâche contrôlée tout en exposant une surface plus large si le répertoire ou les secrets sont mal isolés.
Le budget de contexte ne doit pas être le seul budget surveillé. Une trajectoire longue peut augmenter les occasions d’erreur, les appels coûteux et la quantité de données exposées. Les garde-fous doivent inclure des limites de durée, de nombre d’actions et de portée des fichiers, avec une approbation humaine pour les opérations sensibles.
Construire une comparaison reproductible
Fixez une version de modèle, un jeu de tâches et un budget avant l’essai. Notez les changements du harness et ne mélangez pas une nouvelle stratégie de contexte avec une nouvelle consigne de planification. Répétez les tâches suffisamment pour observer la variabilité, sans présenter une moyenne comme une garantie.
Une comparaison claire peut conclure que le changement n’apporte rien. Cette conclusion est utile : elle évite d’ajouter un composant qui augmente la complexité sans améliorer le résultat. Le papier étudié invite précisément à mesurer les pièces du système au lieu d’attribuer tout gain à l’intelligence apparente du modèle.
Une séquence de déploiement
Commencez en mode observation sur des tâches sans effet externe. Enregistrez les trajectoires et vérifiez que les limites de fichiers, de durée et d’outils sont respectées. Passez ensuite à des tâches où l’agent peut modifier une copie isolée du dépôt. La revue humaine doit porter sur le diff et sur la trajectoire, pas seulement sur le message final.
N’activez une nouvelle stratégie de contexte ou un nouvel espace d’action qu’après avoir défini un retour arrière. Si la consommation augmente, si les tests régressent ou si l’agent touche trop de fichiers, l’équipe doit pouvoir revenir au harness précédent sans migrer tout le workflow. La réversibilité est une partie de la conception, pas une étape de crise.
Ce que signifie un bon harness
Un bon harness n’est pas celui qui ajoute le plus de planification ou d’outils. C’est celui qui rend le comportement mesurable, borne les actions et fournit au modèle le contexte nécessaire pour la tâche. La configuration optimale peut varier selon le modèle, le budget et la structure du dépôt.
Les résultats de l’étude encouragent une approche modulaire. Une équipe peut changer la gestion du contexte sans réécrire toute la boucle, comparer une interface Bash à des outils spécialisés et observer l’endroit où la trajectoire s’arrête. Cette modularité facilite l’apprentissage collectif et évite les conclusions fondées sur une boîte noire.
Résumé opérationnel
Pour commencer, choisissez un petit ensemble de tâches, fixez le modèle et le budget, puis mesurez les trajectoires. Ajoutez une seule modification à la fois, conservez les permissions minimales et gardez un retour arrière. Le harness doit rendre visibles les erreurs et les coûts. Il ne doit pas masquer une action risquée derrière une sortie finale bien formulée.
Cette méthode permet de comparer une amélioration technique à son coût organisationnel. Une trajectoire plus courte n’est pas toujours préférable si elle supprime une vérification importante ; une trajectoire plus longue peut être acceptable si elle évite une régression coûteuse. Le harness doit rendre ce compromis mesurable et réversible.
Critères de sortie
Un essai est exploitable lorsque le modèle, la tâche, le budget, les permissions et la version du harness sont connus. Le rapport doit afficher le résultat du test, le coût et les limites de la trajectoire. Sans ces éléments, un score ne permet pas de distinguer une amélioration reproductible d’un succès accidentel.
Le rapport devrait aussi conserver quelques trajectoires brutes, y compris des échecs. Un résumé agrégé ne montre pas si le modèle a tourné en boucle, si le contexte a débordé ou si une permission a bloqué l’action. Les trajectoires donnent aux ingénieurs une base pour comprendre le mécanisme avant de modifier le harness.
Une dernière revue doit vérifier que l’amélioration ne vient pas d’un relâchement involontaire des garde-fous. Si un agent réussit parce qu’il peut écrire davantage de fichiers ou exécuter une commande plus puissante, le gain doit être présenté avec son coût de sécurité. La comparaison doit porter sur la tâche et sur la surface d’action, pas seulement sur le score.
Un harness exploitable reste donc compréhensible par l’équipe qui devra l’arrêter, le modifier ou l’auditer.
Cette compréhension est une condition pratique de confiance : elle permet de relier un résultat à une configuration précise et de revenir à une version précédente lorsque les coûts ou les risques augmentent.
La comparaison doit également conserver les échecs représentatifs afin de vérifier que le gain ne vient pas seulement d’un jeu de tâches favorable.
Elle doit enfin distinguer le coût de raisonnement, le coût des outils et le coût de vérification humaine.
Ce que l’étude ne prouve pas
Quatre modèles et deux benchmarks ne couvrent pas tous les dépôts, langages ou équipes. Un gain de coût sur une tâche en ligne de commande ne garantit ni une meilleure sûreté, ni une meilleure maintenabilité, ni une absence de régression. Le document est un preprint ArXiv et n’est pas nécessairement évalué par les pairs.
Sources
Run-Ze Fan, Zihao Zhang, Simin Ma, Yebowen Hu et coauteurs, « An Empirical Study of Harness Design for Coding Agents », ArXiv 2609.20804v1, consulté le 21 septembre 2026 : résumé et preprint, PDF.