
Guide · Finance & statistiques
Comparer une activité à sa normale locale : un exercice pour les outils d’agents
Un exemple contrastif montre pourquoi un outil doit exposer l’échelle de décision et pourquoi les volumes bruts peuvent inverser une comparaison.
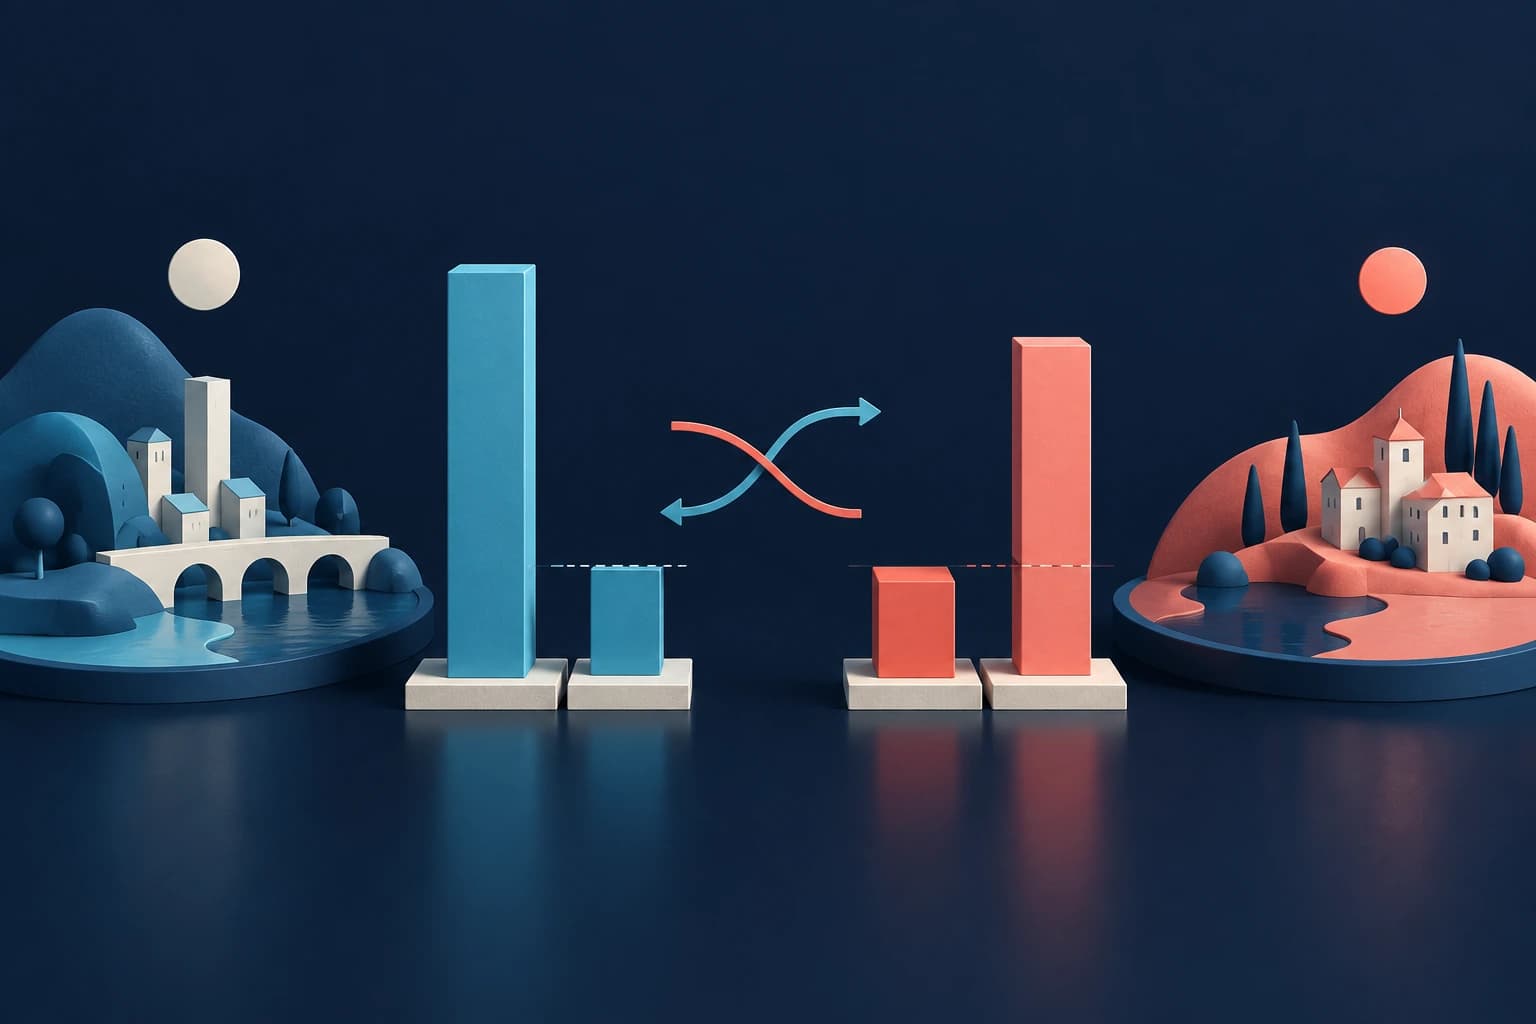
Choisir la question avant le chiffre
« Où observe-t-on le plus d’activité ? » et « où l’activité dépasse-t-elle le plus sa normale ? » ne demandent pas le même calcul. UrbanContrastiveQA étudie cette distinction dans des outils consommés par des LLM.
Le benchmark assemble des comparaisons temporelles, spatiales, météorologiques et entre villes à partir de flux publics américains. Les références sont locales : elles dépendent notamment de la zone, du mois et de l’heure dans la semaine.
Étape 1 — Construire un cas où les ordres s’inversent
Reprenons le cas schématique présenté dans le papier. La zone A a une activité observée de 20, une moyenne de 8 et un écart-type de 6. La zone B a une activité de 180, une moyenne de 250 et un écart-type de 50.
A : écart standardisé = (20 - 8) / 6 = 2,00
B : écart standardisé = (180 - 250) / 50 = -1,40
B a le volume brut le plus élevé. A dépasse davantage sa référence locale. Le calcul n’est utile qu’avec une définition explicite de cette référence ; le score n’est pas automatiquement une probabilité d’anomalie.
Étape 2 — Exposer le contrat de l’outil
Préparer deux sorties fictives : l’une donne seulement les volumes, l’autre ajoute périmètre, moyenne, écart-type et score calculé. Poser exactement la même question de comparaison à chaque fois.
Lorsque l’outil fournit déjà le score, le test mesure la capacité du modèle à l’utiliser. Il ne démontre pas que le modèle sait estimer la référence historique ou calculer le score à partir de données brutes.
Étape 3 — Tester les deux orientations
Présenter A puis B, puis inverser l’ordre. La mesure par paire peut exiger que les deux réponses soient correctes. Cette exigence rend visibles des effets de position qu’une moyenne sur les orientations pourrait atténuer.
Ajouter ensuite des contrôles où les champs numériques sont échangés. Leur interprétation doit être fixée avant l’essai, pour savoir si l’on teste le suivi de l’information fournie ou une préférence liée au nom de la zone.
Ce que rapportent les auteurs
Le corpus contient 432 paires non ordonnées, soit 864 orientations. Les sorties enrichies améliorent les résultats de plusieurs modèles, mais le meilleur format varie. Le sous-ensemble spatial conflictuel est petit : 26 paires.
Une règle déterministe qui compare les scores stockés atteint la référence parfaite par construction. Ce plafond ne constitue pas un résultat de prévision urbaine. Le présent exercice, issu des passages locaux et des résultats officiels, reste un test de représentation des données, sans exécution des modèles du benchmark.
Source et statut
Source principale : Measuring Decision-Scale Use in Tool-Augmented LLMs: A Contrastive Urban Benchmark, prépublication ArXiv 2609.16607v1 · PDF. Les résultats rapportés sont ceux des auteurs ; les conseils de méthode sont une interprétation éditoriale. Publication éditoriale, sans reproduction expérimentale dans cette session.
Compléments officiels effectivement consultés : 3 Results. Lecture partielle ; voir les passages et limites consignés dans la frontmatter.