
Guide · IA & agents
5 outils pour coder avec l’IA en local, sans abonnement
Cinq outils locaux pour coder avec l’IA, du plugin à l’inférence, avec licences, systèmes compatibles, modèles et contraintes matérielles réelles.
Coder avec une IA locale demande plusieurs briques. L’éditeur ou le terminal reçoit votre demande, un agent décide quels fichiers lire ou modifier, puis un moteur d’inférence exécute le modèle. Les cinq outils ci-dessous couvrent ces rôles sans imposer d’abonnement, à condition de choisir un modèle téléchargeable et de fournir la machine qui le fera tourner.
En bref. Cline, Aider et Tabby interviennent dans le travail de code. Ollama et llama.cpp exécutent les modèles. Les logiciels peuvent être utilisés sans abonnement, mais les modèles ont leurs propres licences et occupent parfois plusieurs dizaines de gigaoctets. Commencez sur votre ordinateur actuel avec un petit modèle quantifié, puis augmentez la taille seulement si la mémoire le permet.
L’ordre sert au comptage, pas à établir un classement. Les informations du tableau ont été vérifiées dans les dépôts et documentations officiels le 4 novembre 2026.
| Outil | Rôle principal | Licence du logiciel | Plateformes documentées | Exécution locale |
|---|---|---|---|---|
| Cline | Interface et agent de codage | Apache 2.0 pour le dépôt principal | VS Code et dérivés, JetBrains, terminal, application macOS et Windows | Se connecte à Ollama, LM Studio ou Atomic Chat |
| Aider | Agent de codage en terminal | Apache 2.0 | macOS, Linux, Windows | Se connecte notamment à Ollama |
| Tabby | Assistant de code auto-hébergé | Apache 2.0 hors répertoire ee/ | Serveur Linux ou Docker, extensions VS Code, IntelliJ et Vim/Neovim | Exécute ses modèles sur CPU, CUDA ou Vulkan |
| Ollama | Moteur d’inférence et serveur de modèles | MIT | macOS, Windows, Linux, Docker | API locale et bibliothèque de modèles |
| llama.cpp | Moteur d’inférence bas niveau | MIT | macOS, Windows, Linux et autres cibles documentées | CLI ou serveur compatible OpenAI, modèles GGUF |
Avant de choisir : trois rôles qui ne se remplacent pas
Une interface de codage vit dans l’éditeur. Elle affiche le chat, propose des complétions ou présente un diff avant application. Cline et les extensions Tabby appartiennent à cette couche.
Un agent reçoit un objectif et agit sur le dépôt. Il peut parcourir les fichiers, préparer une modification, appeler le terminal ou lancer des tests selon les permissions accordées. Cline et Aider sont des agents. Cette autonomie augmente aussi le risque : un modèle local n’empêche pas l’agent de supprimer un fichier ou d’exécuter une commande si vous l’autorisez. Le guide sur la sécurisation d’un agent IA local traite cette partie.
Le moteur d’inférence charge les poids du modèle et calcule la réponse. Ollama et llama.cpp font ce travail. Ils ne connaissent pas, à eux seuls, les règles de votre dépôt ni le périmètre d’une tâche. Une même installation peut donc associer Cline à Ollama, ou Aider à un serveur Ollama. Installer deux agents ne donne pas davantage de mémoire au modèle.
1. Cline : un agent dans l’éditeur ou le terminal
Cline est un agent de codage disponible comme extension d’éditeur, application de bureau et outil en ligne de commande. Dans VS Code et JetBrains, il lit le projet, propose des changements multi-fichiers et présente les modifications sous forme de diff. Son mode d’action peut aussi lancer des commandes. La documentation prévoit une approbation humaine avant les éditions et commandes, sauf si vous activez vous-même l’approbation automatique.
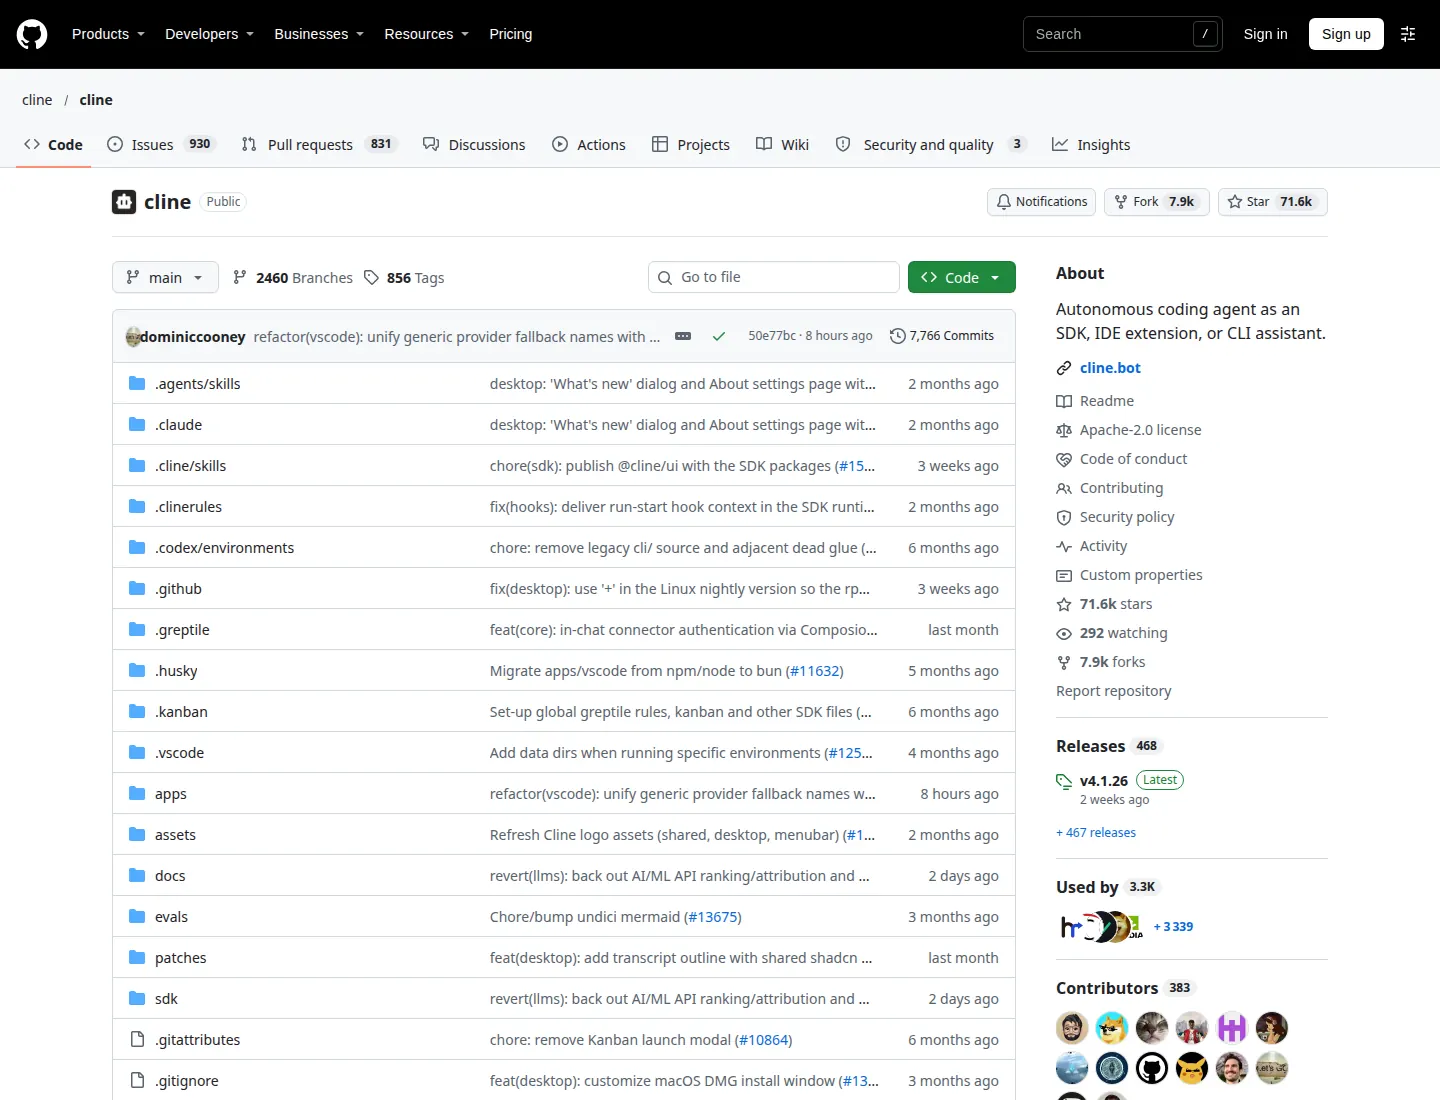
Le dépôt principal est sous licence Apache 2.0. Le README précise toutefois que le plugin JetBrains n’est pas publié dans ce dépôt. Il faut donc éviter d’étendre la licence du cœur à chaque distribution portant le nom Cline.
Plateformes et mode d’exécution
L’extension s’installe dans VS Code, VSCodium, Cursor, Windsurf, Antigravity et les IDE JetBrains. L’application de bureau est documentée pour macOS et Windows, avec Windows encore indiqué en bêta. Le CLI demande Node.js 20 ou une version plus récente.
Pour rester local, Cline doit être relié à un serveur d’inférence sur la machine. La documentation cite trois options : Ollama sur localhost:11434, LM Studio sur localhost:1234 et Atomic Chat sur 127.0.0.1:1337/v1. Elle recommande aussi le prompt compact et des tâches courtes, car un contexte volumineux pèse directement sur la mémoire et le temps de génération.
Modèles, matériel et limite principale
Cline ne fournit pas le modèle local. La compatibilité dépend du moteur choisi et de la capacité du modèle à suivre les demandes d’outils et d’édition. Sa documentation donne des repères prudents : 16 à 32 Go de RAM pour de petits modèles quantifiés, 32 à 64 Go pour des modèles de code intermédiaires, et plus de 64 Go pour les modèles plus grands ou les contextes longs. Ce ne sont pas des garanties de vitesse.
Cline convient si vous voulez examiner chaque diff dans l’éditeur. Son coût caché est le contexte : structure du dépôt, fichiers et sorties de terminal doivent tenir dans la fenêtre du modèle. Un petit modèle peut accepter la requête tout en perdant des éléments utiles sur une tâche trop large.
2. Aider : l’agent qui travaille avec Git dans le terminal
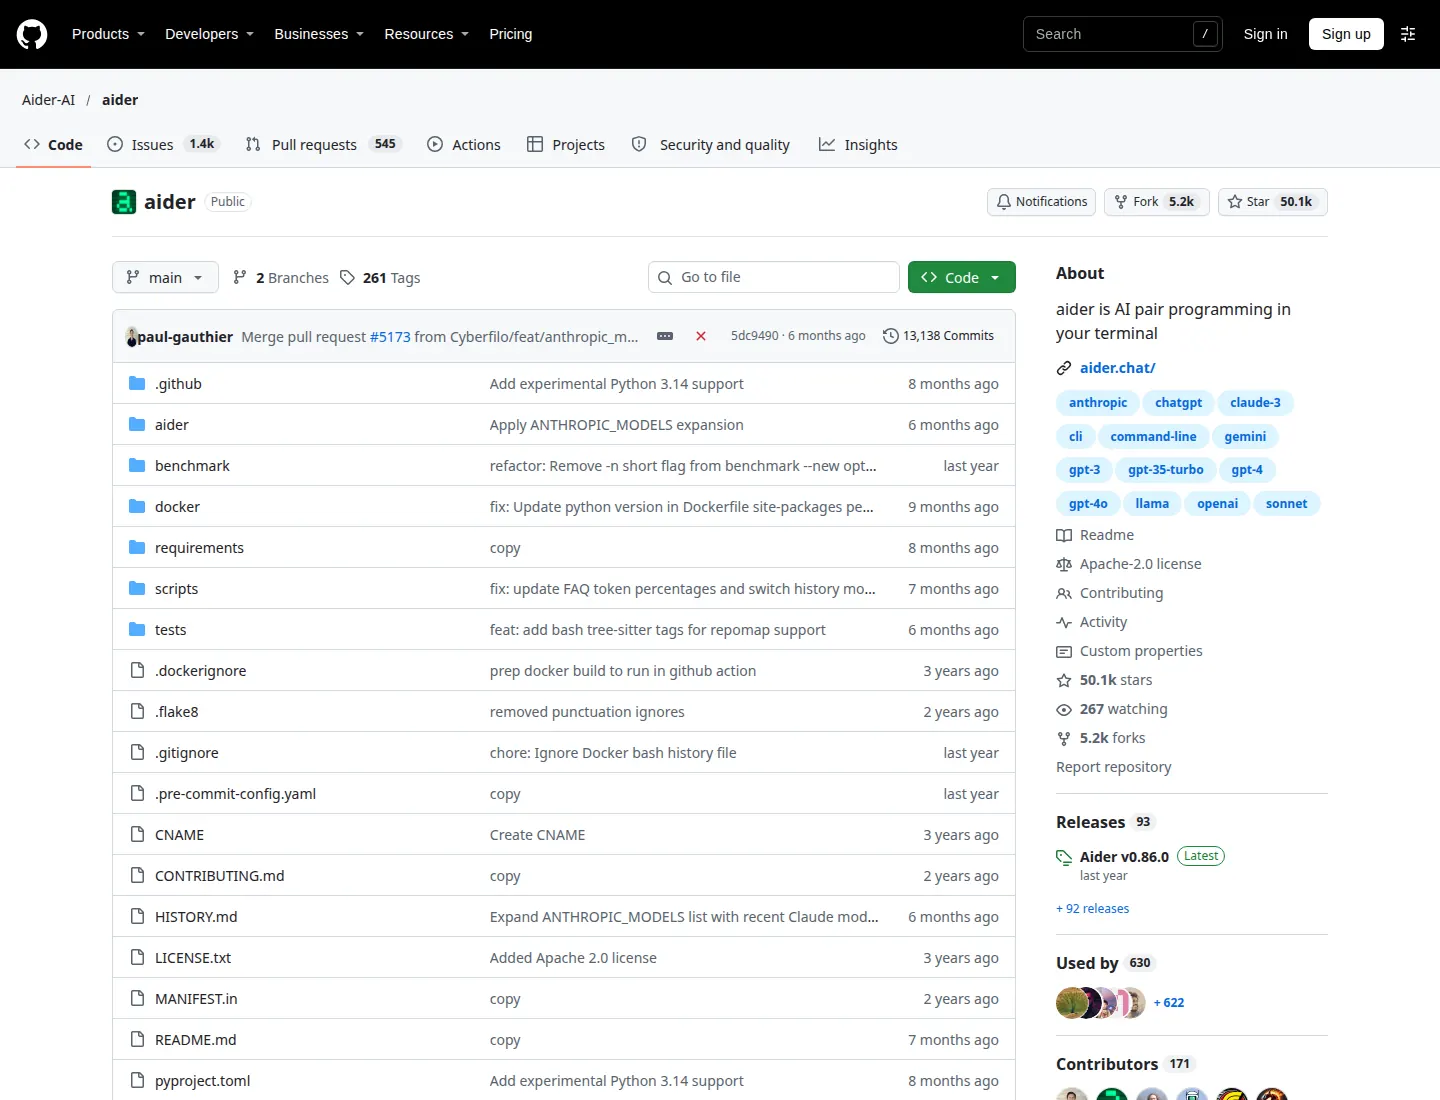
Aider est un agent de pair programming en terminal sous licence Apache 2.0. Il construit une carte du dépôt, modifie les fichiers choisis et s’intègre à Git. Son interface reste légère : vous travaillez dans le répertoire du projet et échangez depuis le shell, sans installer un nouvel éditeur.
Plateformes et mode d’exécution
La procédure officielle couvre macOS, Linux et Windows. L’installateur accepte Python 3.8 à 3.13 et place Aider dans un environnement séparé. Une installation avec uv, pipx ou pip est aussi documentée. L’outil lui-même tourne localement ; le modèle peut être local ou distant selon la configuration.
Pour une chaîne sans abonnement, la documentation donne un chemin précis avec Ollama. Vous démarrez le serveur Ollama, placez son adresse dans OLLAMA_API_BASE, puis sélectionnez un modèle avec le préfixe ollama_chat/. Aider recommande ce préfixe plutôt que ollama/.
Backends, modèles et contrainte de contexte
Aider se connecte à de nombreux fournisseurs et à des modèles locaux. Dans le montage documenté avec Ollama, le choix réel du modèle vient de la bibliothèque Ollama. Aider peut afficher un avertissement lorsqu’il ne connaît pas les métadonnées d’un modèle. L’avertissement ne prouve pas que le modèle est incompatible ; il signale que la configuration n’est pas connue de l’outil.
La limite la plus concrète est la fenêtre de contexte. La page Ollama d’Aider prévient qu’un contexte insuffisant peut écarter silencieusement une partie des données envoyées. Aider ajuste la taille demandée, ce qui augmente en retour l’usage mémoire. Sur un gros dépôt, il vaut mieux ajouter les fichiers nécessaires à la tâche plutôt que d’envoyer tout le projet.
Aider est adapté si Git et le terminal sont déjà au centre de votre méthode. Il faut tout de même relire le diff et exécuter les tests du projet. Une modification produite localement n’est pas validée par le seul fait qu’elle n’a pas quitté la machine.
3. Tabby : complétion et chat depuis un serveur auto-hébergé
Tabby associe un serveur d’IA auto-hébergé à des extensions d’éditeur. L’extension VS Code propose la complétion, le chat, l’explication d’une sélection et l’édition en ligne. Des clients sont aussi documentés pour la plateforme IntelliJ et Vim ou Neovim.
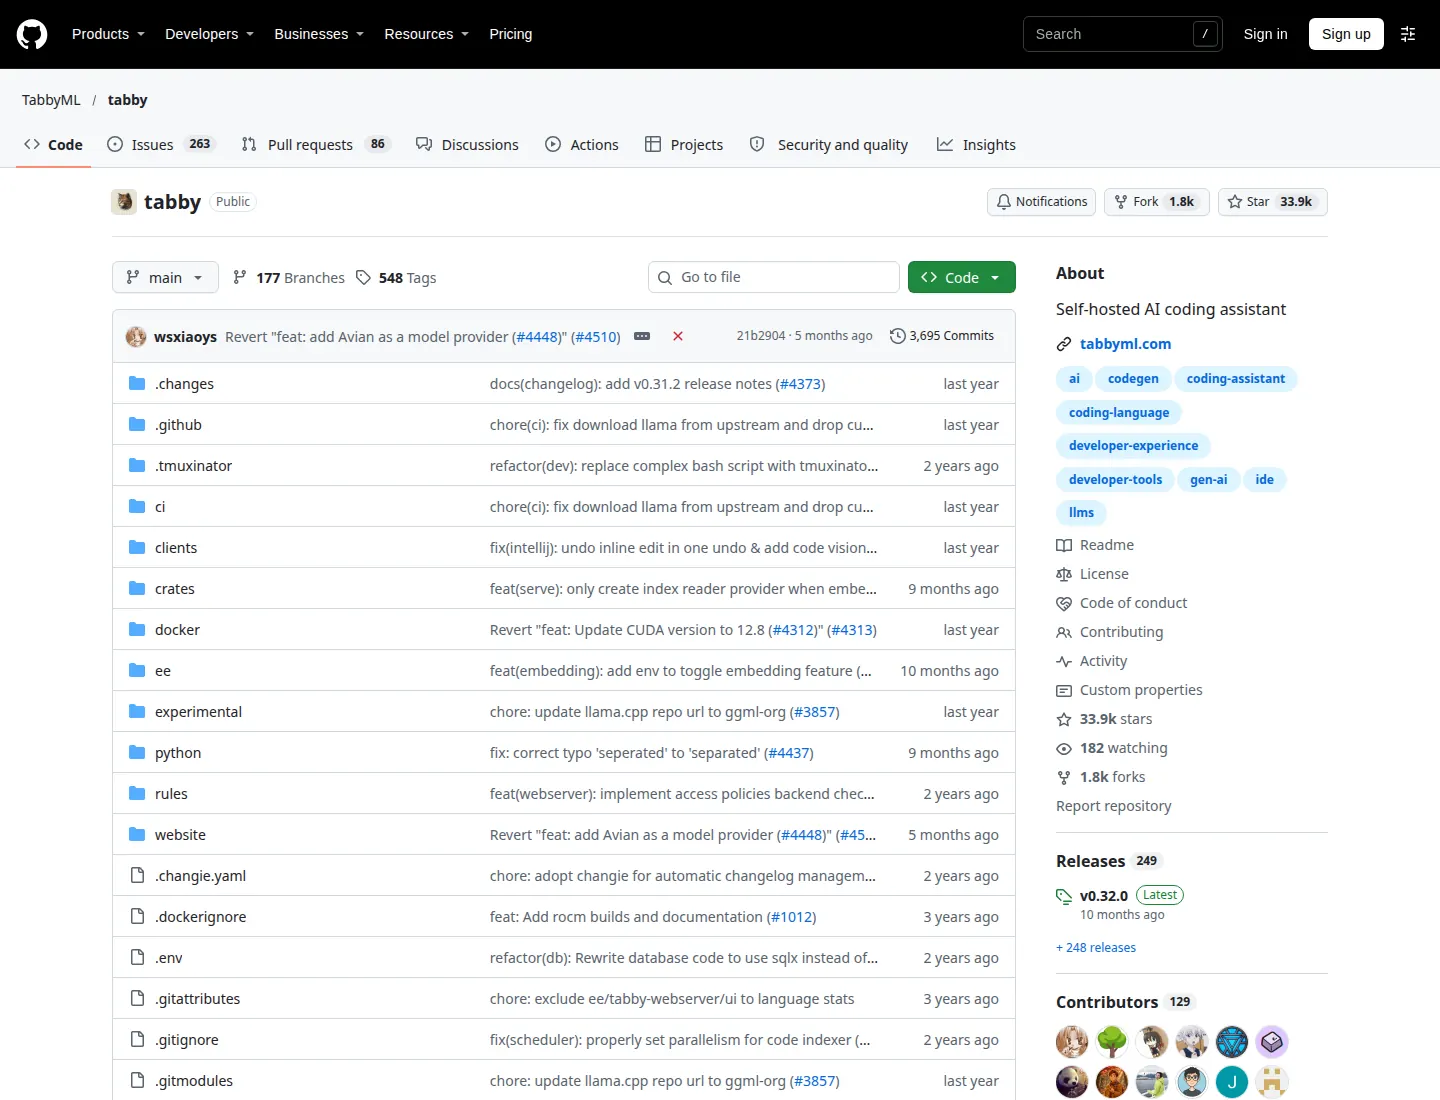
La licence demande une lecture attentive. Le contenu du dépôt hors répertoire ee/ est sous Apache 2.0. Le contenu éventuel de ee/ suit sa propre licence. Cette séparation compte si vous redistribuez Tabby ou si vous examinez une fonction d’entreprise.
Exécution et modèles compatibles
Le serveur peut fonctionner sur Linux avec un exécutable autonome ou dans Docker. Tabby publie des distributions CPU, CUDA et Vulkan. L’extension se connecte ensuite à l’URL du serveur et utilise un jeton de compte.
Le registre officiel sépare les modèles de complétion, de chat et d’embeddings. Il répertorie notamment les familles StarCoder, CodeLlama, DeepSeek Coder, CodeGemma et Qwen Coder, chacune avec sa propre licence. Le serveur peut donc être sous Apache 2.0 tandis que le modèle impose d’autres conditions. Vérifiez les deux textes avant un usage professionnel ou une redistribution.
Limites matérielles
Tabby recommande au moins un GPU NVIDIA T4, une carte des séries 10 ou 20, ou une puce Apple M1 pour les modèles de 1 à 3 milliards de paramètres. Pour les modèles de 7 à 13 milliards de paramètres, sa documentation cite les V100, A100 et séries NVIDIA 30 ou 40. Ce sont les repères de l’éditeur, pas des mesures réalisées pour cet article.
Le mode CPU existe, mais la documentation ne promet pas une latence confortable. Tabby demande aussi davantage de mise en place que Cline : un serveur, un modèle de complétion, éventuellement un modèle de chat, puis l’extension. Cette architecture devient intéressante quand plusieurs éditeurs doivent partager le même serveur local ou quand la complétion est prioritaire.
4. Ollama : le serveur local facile à brancher
Ollama est un moteur d’inférence sous licence MIT. Il télécharge, charge et sert des modèles depuis macOS, Windows, Linux ou Docker. Son API locale écoute par défaut sur localhost:11434, ce qui permet à Cline, Aider et d’autres clients de lui envoyer des requêtes.
Ollama n’est pas un agent de codage. Il ne décide pas quels fichiers modifier et ne remplace pas l’interface de votre éditeur. Son rôle est d’exécuter le modèle et d’exposer une API. Cette séparation simplifie les essais : vous pouvez changer d’agent tout en gardant le même serveur.
Backends et modèles
Le projet indique llama.cpp parmi ses backends pris en charge. La bibliothèque Ollama propose plusieurs familles de modèles, et le moteur peut aussi importer des modèles selon les formats documentés par le projet. La licence MIT d’Ollama ne couvre pas les poids téléchargés. Chaque fiche de modèle doit être relue séparément.
L’accélération matérielle couvre Metal sur les appareils Apple, CUDA sur les GPU NVIDIA compatibles, ROCm sur une liste de GPU AMD, ainsi que Vulkan sur Windows et Linux. Le CPU reste utilisable lorsque le GPU n’est pas disponible ou lorsque vous le désactivez.
Limites matérielles
Ollama ne donne pas une quantité universelle de RAM. La mémoire requise dépend du modèle, de sa quantification et de la longueur de contexte. Un modèle qui tient tout juste en mémoire avec un petit contexte peut échouer ou ralentir lorsque l’agent ajoute de nombreux fichiers. La documentation NVIDIA demande une capacité de calcul 5.0 ou plus et des pilotes récents ; les anciennes cartes de capacité 5.0 à 6.2 demandent un pilote encore plus récent dans la page consultée.
Le comparatif Ollama, LM Studio et Open WebUI détaille les différences entre serveur, application et interface. Si vous partez de zéro, le guide sur le matériel pour l’IA locale aide à dimensionner la mémoire avant tout achat.
5. llama.cpp : le moteur bas niveau pour les modèles GGUF
llama.cpp est un moteur d’inférence C et C++ sous licence MIT. Il peut lancer un modèle depuis le terminal ou publier un serveur HTTP compatible avec l’API OpenAI. Les versions précompilées, Docker et la compilation depuis les sources sont documentés.
Comme Ollama, llama.cpp n’est ni une interface de code ni un agent. Il convient aux personnes qui veulent contrôler le format du modèle, le backend matériel et les paramètres du serveur. Cette souplesse demande davantage de configuration.
Plateformes, backends et modèles
Le projet cible macOS, Windows et Linux, avec des instructions supplémentaires pour Android et plusieurs architectures. Il prend en charge le CPU et de nombreux backends : Metal pour Apple Silicon, CUDA pour NVIDIA, HIP pour AMD, SYCL pour les GPU Intel et Vulkan pour plusieurs familles de GPU. Il sait aussi répartir une partie du calcul entre CPU et GPU lorsque le modèle dépasse la mémoire vidéo.
Le format courant est GGUF. Le démarrage rapide montre le téléchargement d’un dépôt GGUF depuis Hugging Face, puis son lancement avec le CLI ou le serveur. La présence d’un fichier GGUF ne garantit pas que son architecture est prise en charge par votre version de llama.cpp. Consultez la documentation du modèle et utilisez une version récente du moteur.
Limites matérielles
La quantification sur 2 à 8 bits réduit la mémoire nécessaire, avec un compromis sur la fidélité du modèle. Le fichier du modèle, son cache de contexte et les couches envoyées au GPU doivent tenir dans la RAM, la mémoire unifiée ou la VRAM disponible. Le serveur peut fonctionner uniquement sur CPU, mais le projet ne promet pas qu’un gros modèle restera agréable pour un agent interactif.
llama.cpp est un bon choix si vous avez besoin d’un serveur minimal ou d’un backend précis. Ollama est plus simple pour gérer une bibliothèque de modèles. Dans les deux cas, le choix d’un PC portable pour le code et l’IA locale doit partir du modèle et de sa mémoire, pas du nom commercial de la machine.
Comment choisir votre chaîne locale
Pour travailler depuis VS Code avec validation visuelle des changements, commencez par Cline et reliez-le à Ollama. Pour rester dans Git et le terminal, Aider avec le même serveur évite de changer de moteur. Si votre besoin principal est la complétion dans plusieurs éditeurs, Tabby réunit le serveur et les extensions, au prix d’une configuration plus longue.
Choisissez llama.cpp lorsque vous voulez régler directement le backend, servir un fichier GGUF ou intégrer le moteur à un autre programme. Choisissez Ollama lorsque la gestion des modèles et une API locale prête à l’emploi comptent davantage que le contrôle fin de la compilation.
Avant de télécharger un modèle, vérifiez quatre points : sa licence, la taille du fichier quantifié, la mémoire recommandée et la longueur de contexte. Gardez aussi de l’espace disque pour plusieurs variantes. « Sans abonnement » signifie ici que ces logiciels peuvent fonctionner sur votre matériel sans forfait mensuel. Cela ne signifie ni matériel gratuit, ni électricité gratuite, ni téléchargement facultatif des modèles.
Questions fréquentes
Peut-on coder avec une IA locale sans carte graphique ?
Oui, Ollama, Tabby et llama.cpp documentent une exécution sur CPU. Le modèle doit toutefois tenir dans la RAM, et le temps de réponse peut être trop long pour un agent interactif. Commencez avec un petit modèle quantifié avant de décider si un GPU est nécessaire.
Cline et Aider exécutent-ils eux-mêmes le modèle ?
Non. Ils organisent la tâche de codage et envoient les requêtes à un backend. Dans une installation locale, Ollama, LM Studio, Atomic Chat ou un autre serveur compatible exécute le modèle selon l’outil choisi.
Un modèle local empêche-t-il toute fuite de code ?
Pas automatiquement. Le moteur peut rester local alors qu’un plugin, un serveur MCP, une commande shell ou une télémétrie utilise le réseau. Vérifiez chaque composant, limitez les permissions de l’agent et contrôlez les connexions sortantes.
Faut-il choisir Ollama ou llama.cpp ?
Ollama offre une gestion de modèles et une API faciles à brancher. llama.cpp expose davantage de réglages et de backends, mais demande plus de manipulation. Les deux projets sont liés techniquement, puisque le dépôt Ollama cite llama.cpp parmi ses backends.
Les modèles de code sont-ils tous libres d’usage commercial ?
Non. La licence du logiciel d’inférence et celle du modèle sont deux documents distincts. Tabby affiche par exemple des modèles sous Apache 2.0, BigCode OpenRAIL-M, licence Gemma ou licences propres à leur éditeur.
Sources
Sources officielles consultées le 4 novembre 2026 :
- Cline, dépôt officiel et licence, installation et modèles locaux
- Aider, dépôt officiel et licence, installation et connexion à Ollama
- Tabby, dépôt officiel, licence, extensions et registre des modèles
- Ollama, dépôt officiel et licence et compatibilité matérielle
- llama.cpp, dépôt officiel et licence et guide de compilation