
Article · SaaS & dev
Accélérer Swing : choisir entre approximation utile et Top-K certifié
ASC et K-ASC réduisent le coût de recherche sur graphes utilisateur–élément, avec une distinction essentielle entre précision observée et certification.
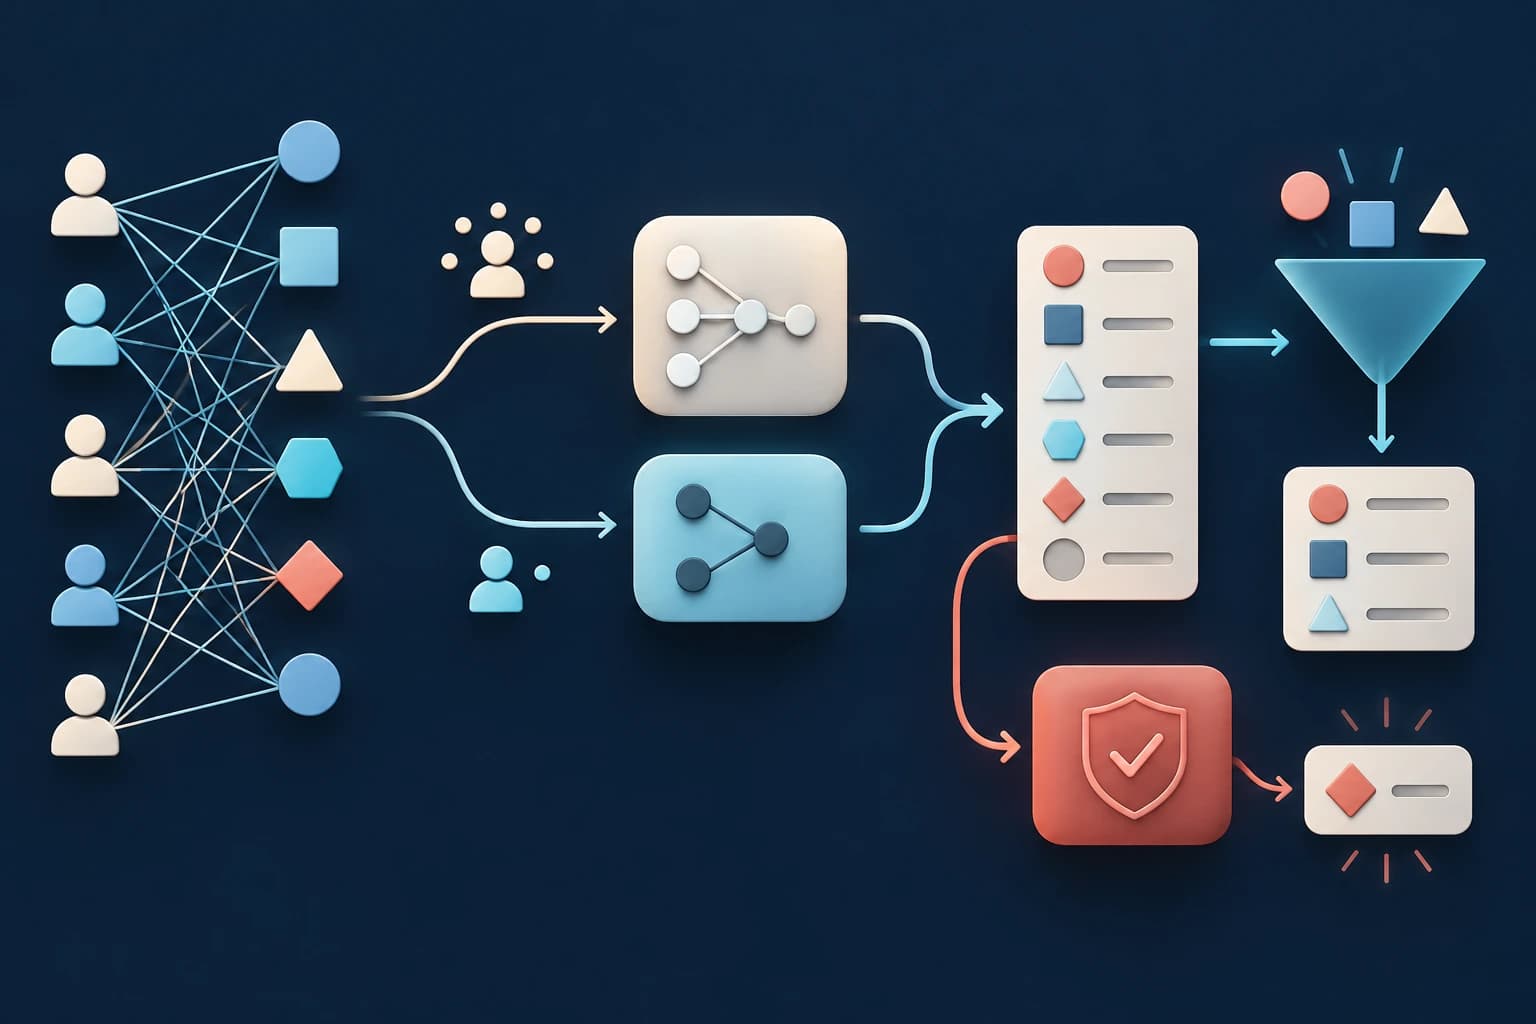
Le coût dépend de la structure du graphe
Swing exploite un graphe d’interactions entre utilisateurs et éléments pour rechercher des éléments proches. Le calcul met en jeu des voisinages et des intersections dont le coût varie fortement selon les degrés.
Le papier propose ASC, qui choisit entre deux estimateurs selon un modèle analytique de coût. L’idée n’est pas qu’un seul échantillonnage serait optimal partout : les approches sont complémentaires entre éléments peu et très connectés.
Chercher les premiers rangs change le problème
K-ASC vise directement les meilleurs candidats. Une première approximation produit un ensemble prometteur, puis un affinage réduit l’incertitude sur les éléments utiles au Top-K.
L’observation rapportée est qu’obtenir une liste légèrement plus large contenant presque tous les bons candidats peut coûter moins cher qu’estimer immédiatement avec précision les K premiers. Ce filtrage reste à distinguer d’une preuve que l’ordre final est exact.
Trois contrats de sortie différents
Une approximation de score décrit une erreur sous certaines conditions. Une précision empirique décrit ce qui a été observé sur les essais. Une certification des premiers rangs exige de séparer suffisamment les bornes des candidats à la frontière.
La section officielle compare la version heuristique K-ASC à C-KASC, qui certifie le Top-K par séparation de bornes de confiance. Cette certification consomme davantage d’échantillons. Les auteurs retiennent l’heuristique comme solution principale de compromis.
Il serait donc incorrect de reprendre simultanément la meilleure vitesse de l’heuristique et la garantie de la variante certifiée comme si elles appartenaient à une seule configuration.
Lire les performances avec leur référence
Le papier rapporte de fortes accélérations sur certains jeux, notamment face au calcul exact. Ces rapports dépendent du graphe, de K, de la qualité demandée et de la méthode de référence.
Pour un essai propre, conserver le même graphe, rapporter construction et mémoire des structures auxiliaires, puis mesurer qualité et temps par classe de degré. Le nombre moyen d’éléments proches ne décrit pas à lui seul les requêtes les plus coûteuses.
Le distribué reste une extension discutée
L’annexe officielle décrit comment répartir les voisinages et les contributions de paires entre plusieurs travailleurs. Elle précise que les expériences du papier sont effectuées sur un seul nœud.
La possibilité de décomposer le calcul ne remplace donc pas une mesure du réseau, de la répartition de charge ou de la latence d’un déploiement distribué. Cette analyse repose sur des passages locaux et deux sections officielles ; les démonstrations mathématiques complètes ne sont pas attestées comme lues.
Source et statut
Source principale : Efficient Swing Computation for Retrieval in Large-Scale Recommender Systems, prépublication ArXiv 2609.16850v1 · PDF. Les résultats rapportés sont ceux des auteurs ; les conseils de méthode sont une interprétation éditoriale. Publication éditoriale, sans reproduction expérimentale dans cette session.
Compléments officiels effectivement consultés : 6.7. Correctness-Efficiency Trade-off of K K - ASC · C.8. Discussion on Scalability and Sharded Deployment. Lecture partielle ; voir les passages et limites consignés dans la frontmatter.