
Article · IA & agents
Raffiner une politique visuelle par échantillonnage
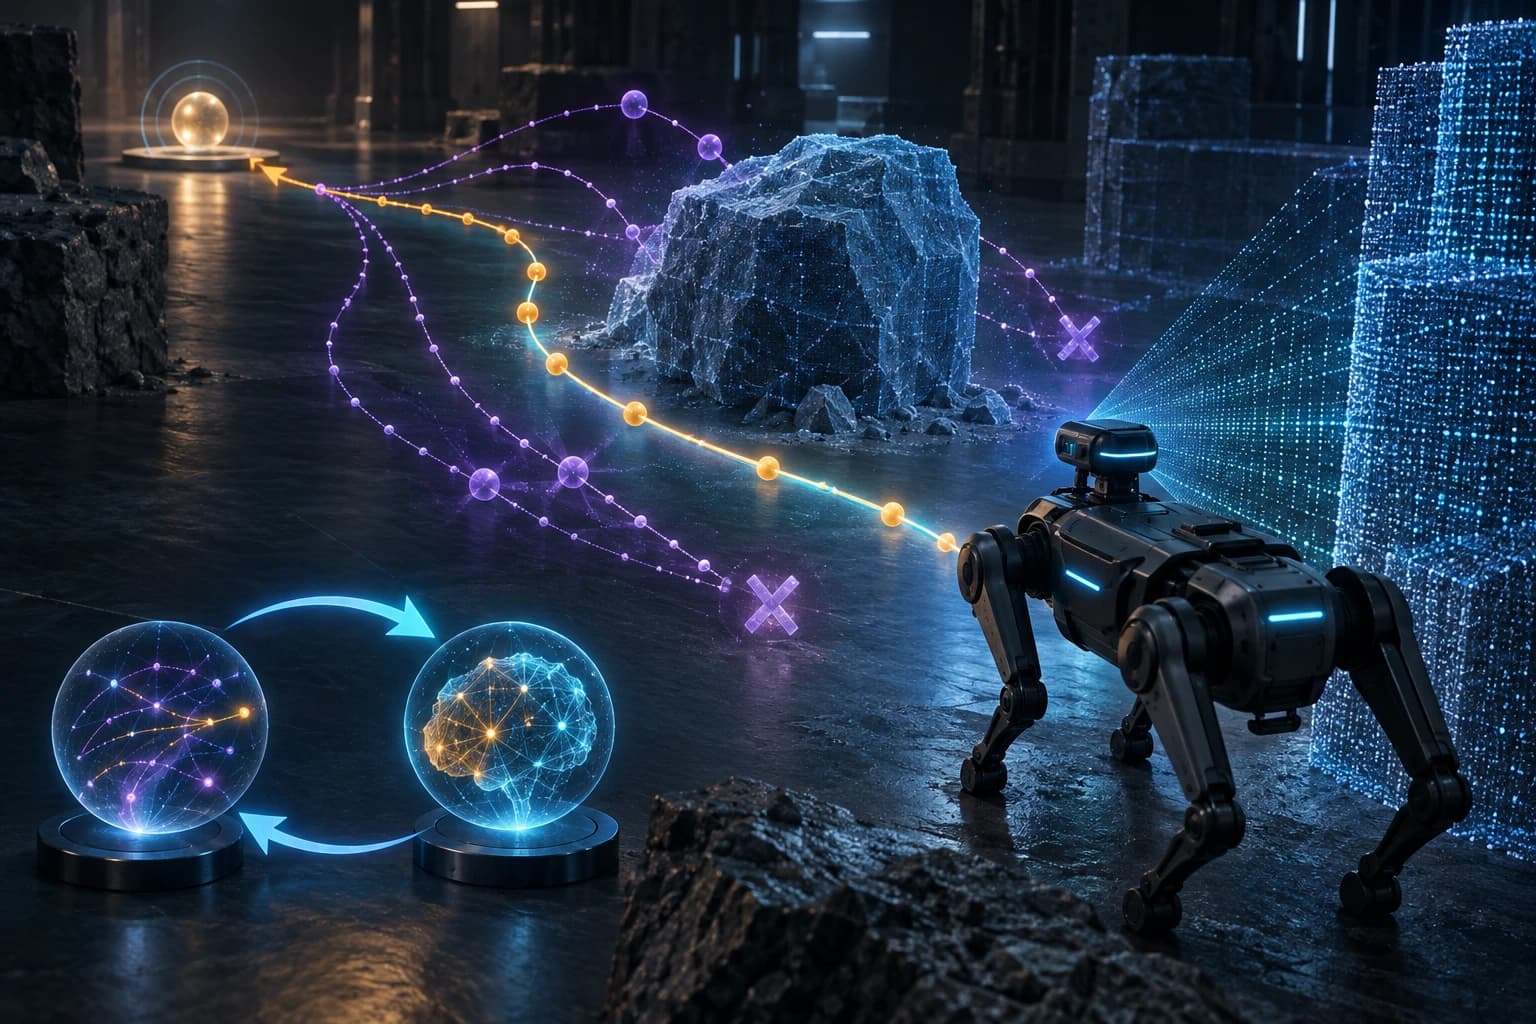
SGPS combine une recherche d'actions par MPC et une optimisation de politique pour éviter des contacts locaux indésirables.
Le gradient ne voit pas tous les chemins
L'apprentissage de politiques visuelles doit coordonner le contact avec l'environnement. Une optimisation locale peut converger vers un schéma de contact indésirable. Yilang Liu, Haoxiang You, Qian Wang, Daniel Rakita et Ian Abraham proposent Sampling-Guided Policy Search, ou SGPS, pour injecter une recherche d'actions dans cette boucle.
Alternance entre MPC et optimisation
SGPS affine périodiquement les cibles d'action par un contrôle prédictif fondé sur l'échantillonnage, puis applique de courtes mises à jour de policy gradient du premier ordre. Un clonage comportemental initialise la politique à partir des actions échantillonnées. Les étapes alternent sous des états initiaux perturbés et des dynamiques randomisées.
Pour les politiques visuelles, la formulation découplée exclut le rendu du graphe de calcul. Le modèle peut ainsi apprendre directement depuis des observations de profondeur sans professeur qui fournisse l'état complet.
Résultats rapportés
Sur un seul GPU, les auteurs apprennent des politiques pour la locomotion, le franchissement d'obstacles, la poussée de caisse et le portage bimanal sur des robots Unitree Go2 et G1 simulés. La recherche améliore l'apprentissage au-delà de l'initialisation et du simple suivi. Une politique distillée est transférée sans entraînement supplémentaire sur un Go2 réel et utilise la profondeur pour changer de comportement.
Interprétation éditoriale : proposer, puis vérifier les actions
Dans un agent logiciel, une recherche de candidats peut compléter une politique apprise lorsque les conséquences sont difficiles à différencier localement. Le contrôleur doit cependant conserver une fonction de coût, des bornes et des tests de sécurité indépendants. Une action trouvée par exploration n'est pas automatiquement admissible.
Limites et statut de la source
Les résultats concernent les robots, tâches et dynamiques du protocole. Le transfert réel ne garantit pas une robustesse générale aux variations d'environnement. Le document est un preprint ArXiv.
Source
Yilang Liu, Haoxiang You, Qian Wang, Daniel Rakita et Ian Abraham, « Accelerating Visual Policy Learning with Sampling-Based Model Predictive Control », ArXiv 2609.20575v1 : résumé et preprint, PDF.