
Article · IA & agents
Cornes lagrangiennes spéciales : quand la géométrie éclaire les réseaux profonds
Une lecture accessible de la géométrie des variétés équilibrées dans les réseaux linéaires profonds.
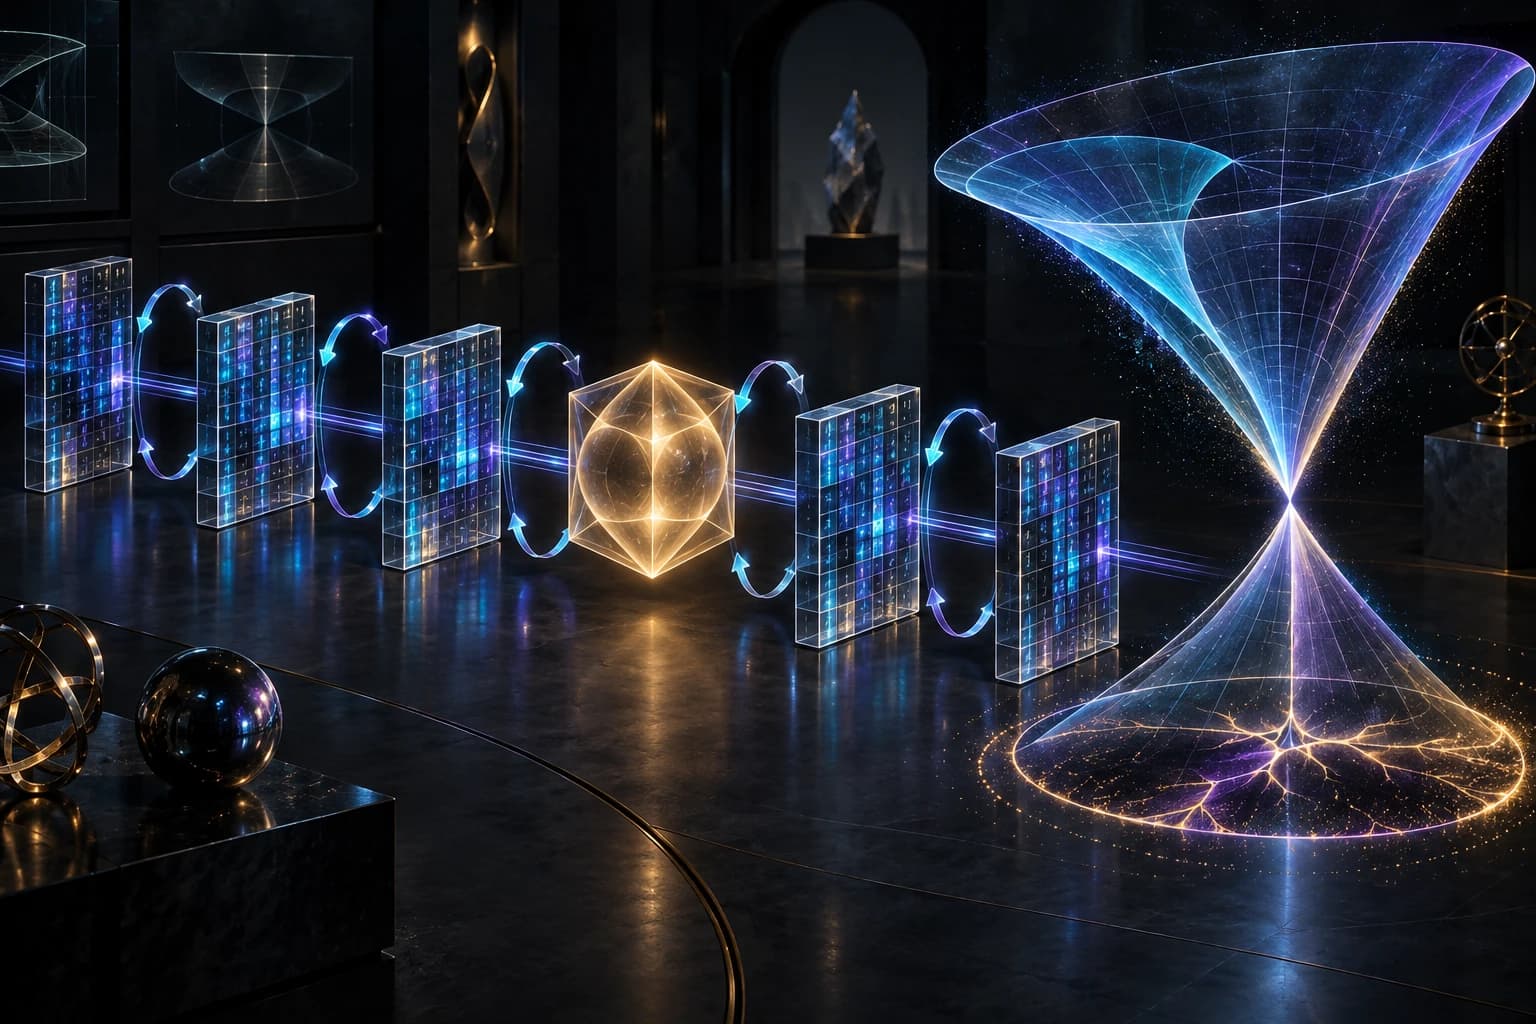
Les réseaux linéaires profonds ont une propriété surprenante : lorsqu’ils sont équilibrés, leurs matrices de poids ne forment pas seulement une famille commode pour l’optimisation. Elles dessinent aussi une variété géométrique dotée d’une structure très rigide. L’article de Tejas Kotwal et Govind Menon relie cette structure à la géométrie lagrangienne spéciale et généralise la corne de Harvey–Lawson aux produits de matrices complexes.
L’équilibre comme contrainte géométrique
Pour un réseau de profondeur (N), l’équilibre impose que les produits (W_kW_k^*) et (W_{k+1}^*W_{k+1}) coïncident entre couches voisines. Ces égalités sont aussi des lois de conservation du flot de gradient d’un réseau linéaire profond. Elles décrivent la variété équilibrée, c’est-à-dire l’espace où la factorisation du produit global ne favorise aucune couche.
Les auteurs isolent ensuite la composante dont le produit final est hermitien défini positif. Grâce à une décomposition polaire, chaque point peut être décrit par une matrice positive (P) et une chaîne de facteurs unitaires. Cette représentation transforme une contrainte matricielle compliquée en une géométrie de facteurs partageant le même spectre positif.
Une généralisation matricielle de Harvey–Lawson
Le résultat central affirme que cette sous-variété est lagrangienne spéciale et exacte dans l’espace de matrices complexes. Elle est donc calibrée, minimale et localement minimisante pour le volume. Lorsque la largeur matricielle vaut un, on retrouve la corne classique de Harvey–Lawson privée de son sommet. La construction conserve ainsi l’intuition scalaire tout en l’étendant à des couches matricielles et à des profondeurs arbitraires.
Cette lecture donne un vocabulaire utile pour les agents qui analysent des trajectoires d’optimisation : l’équilibrage n’est pas uniquement une régularité numérique, mais une contrainte qui organise l’espace des paramétrisations équivalentes. Les changements de base unitaires décrivent les symétries internes du réseau, tandis que le facteur positif encode la composante réellement partagée entre les couches.
Pourquoi cela intéresse les systèmes d’IA
La géométrie ne fournit pas ici un nouvel algorithme d’entraînement prêt à l’emploi. Elle fournit plutôt une carte conceptuelle : deux factorisations peuvent représenter la même application, mais la factorisation équilibrée est sélectionnée par un principe de minimisation de norme. Pour l’audit d’un système, cette perspective aide à séparer les degrés de liberté liés au choix de représentation des propriétés qui persistent dans le produit de bout en bout.
Les résultats sur les adhérences montrent aussi ce qui se passe lorsque le facteur positif devient seulement semi-défini positif. La frontière autorise des pertes de rang et fait apparaître des factorisations dégénérées. Cette extension est pertinente pour raisonner sur la robustesse structurelle, mais elle ne doit pas être confondue avec une garantie de robustesse statistique sur des données réelles.
Limites
Le travail est théorique et porte sur des réseaux linéaires, des matrices complexes ou réelles et des hypothèses de régularité précises. Il ne mesure ni gain de généralisation, ni stabilité d’un entraînement non linéaire, ni bénéfice opérationnel pour un agent déployé. La traduction vers des architectures modernes exige donc des résultats supplémentaires, notamment sur les activations, les pertes non quadratiques et les effets de la discrétisation numérique.
Sources
- Preprint ArXiv 2609.20159v1, Special Lagrangian cones in Deep Learning.
- Résumé ArXiv
- PDF ArXiv