
Article · SaaS & dev
ANGLE : simplifier la recherche publicitaire sans faire disparaître le classement
ANGLE combine génération, discrimination et préférence, mais conserve un classement final et des résultats commerciaux propres au protocole étudié.
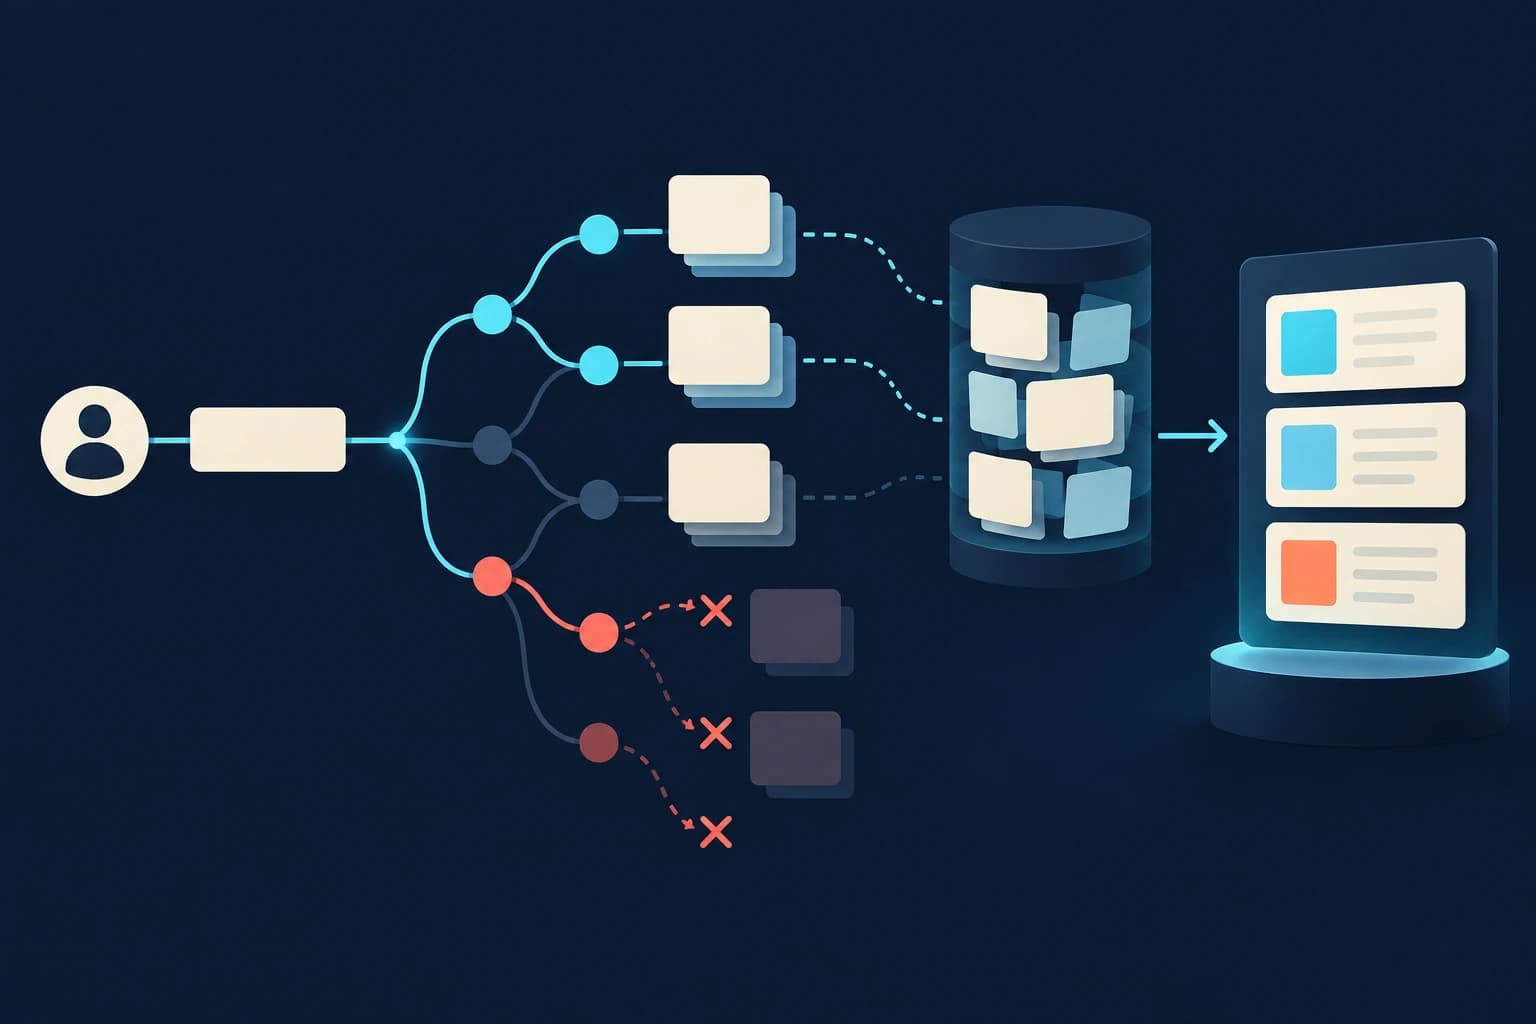
Ce que « une étape » recouvre
ANGLE propose de rapprocher plusieurs objectifs dans la récupération d’annonces sponsorisées. Son modèle génère des représentations textuelles qui servent à retrouver des annonces dans un index, puis envoie les candidats au classement.
Le titre du papier peut suggérer une suppression de toute la cascade. Les limites disent explicitement que le classement reste nécessaire, notamment pour les composants liés aux enchères et à la sélection des créations. Le changement porte sur le chemin de récupération, pas sur la disparition de toute décision ultérieure.
Deux niveaux de représentation
Chaque annonce est reliée à une intention générale et à un résumé plus précis. L’intention représente une catégorie de besoin ; le résumé reprend des termes liés au titre de l’annonce. Un index inversé associe ces paires aux annonces.
La section officielle décrit l’actualisation de cet index pour de nouvelles annonces sans réentraîner le modèle sur chaque nouvelle association. Il faut distinguer cette propriété du travail de génération et de validation des représentations, qui reste nécessaire.
Une génération contrainte par les candidats valides
Le décodage consulte la validité des annonces associées aux branches explorées. Les résumés sans annonce valide sont retirés des candidats ; une intention sans branche valide est également écartée. Comme l’ensemble admissible dépend de l’utilisateur, l’arbre utile est dynamique.
La pertinence sémantique et l’éligibilité opérationnelle sont donc deux filtres distincts. Un résultat textuellement convaincant ne devient pas une annonce admissible par sa seule génération.
Ce que permettent les résultats rapportés
Le preprint décrit un test A/B de cinq jours portant sur 20 % du trafic et des évaluations hors ligne. Ces observations sont propres aux systèmes et au dispositif des auteurs ; elles ne constituent pas une prévision de revenus pour un autre service.
Une anomalie demande relecture avant toute reprise commerciale : le paragraphe de résultats en ligne cite 1,18 % pour la consommation, tandis que la table officielle présente 1,81 % pour WTS, avec d’autres valeurs pour QBS. Le brouillon conserve cette divergence sans choisir arbitrairement un chiffre.
Points à mesurer dans un prototype
Pour examiner l’idée, mesurer séparément couverture de l’index, validité des candidats, pertinence et qualité du classement final. Journaliser les branches éliminées aide à déterminer si une perte de rappel vient de la représentation ou des contraintes d’éligibilité.
Ces pistes constituent une lecture d’architecture, pas un tutoriel d’intégration ni une recommandation publicitaire. Les passages locaux ont été complétés par les sections officielles sur l’index et les limites ; aucune reproduction du test A/B n’a été effectuée.
Source et statut
Source principale : One-Step Retrieval Framework for Real-Time Sponsored Search Ads Using Hierarchical Text Representations, prépublication ArXiv 2609.18296v1 · PDF. Les résultats rapportés sont ceux des auteurs ; les conseils de méthode sont une interprétation éditoriale. Publication éditoriale, sans reproduction expérimentale dans cette session.
Compléments officiels effectivement consultés : Limitations · 3.3 Ad Indexing. Lecture partielle ; voir les passages et limites consignés dans la frontmatter.